
Fassen Sie diesen Blogbeitrag wie folgt zusammen:
| The Databricks Lakehouse unifies warehouse and lake into one open platform, eliminating duplicate pipelines and solving reliability, governance, orchestration, and cost challenges in data engineering. |
TL;DR: Fragmented data stacks are ineffective because their tools are not integrated with one another. To address this problem, Databricks Lakehouse comes into play. Databricks Lakehouse solves five core problems: duplicate pipelines, reliability, governance, orchestration, and cost. Sequencing matters: provision Unity Catalog first, enforce compute governance early, and adopt Lakeflow Pipelines before manual orchestration becomes a liability.
Die meisten Data-Engineering-Teams in Unternehmen scheitern nicht an fehlenden Werkzeugen. Sie scheitern vielmehr, weil die in den letzten zehn Jahren angesammelten Werkzeuge nie für die Zusammenarbeit konzipiert wurden.
Ein Data Warehouse für Reporting. Ein Data Lake für Skalierung. Eine separate ML-Umgebung. Eine Streaming-Schicht, die hinzugefügt wurde, als die Batch-Verarbeitung nicht mehr ausreichte. Jede dieser Entscheidungen war zum damaligen Zeitpunkt sinnvoll. Die daraus entstandene Architektur ist es nicht mehr.
Wissen Sie?
- Over a quarter of organisations estimate they lose more than $5 million a year to poor data quality, with 7% losing $25 million or more.
- AI spending is forecast to surpass $2 trillion in 2026 at 37% year-over-year growth , and when AI investment scales, the cost of poor data quality scales with it.
Databricks Lakehouse ersetzt die fragmentierte Architektur durch eine einzige offene Plattform. Dieser Blogbeitrag erläutert die spezifischen Herausforderungen im Bereich Data Engineering, die die Databricks-Lakehouse-Architektur löst – und wie diese Lösung funktioniert.
Bevor wir uns mit einzelnen Herausforderungen befassen, ist es wichtig, genau zu definieren, was die Databricks Lakehouse-Plattform eigentlich ist – denn diese Definition prägt jede nachfolgende Implementierungsentscheidung.
Das Databricks Data Lakehouse ist kein Data Warehouse mit zusätzlichen Data-Lake-Funktionen und auch kein Data Lake mit nachträglich hinzugefügter Data-Lake-Governance. Es handelt sich um eine einzige offene Plattform, die die Transaktionssicherheit, die Schema-Durchsetzung und die Abfrageleistung eines Data Warehouse bietet und gleichzeitig die Skalierbarkeit, Offenheit und ML-Kompatibilität eines Data Lakes beibehält. Die Lakehouse-Architektur auf Databricks basiert auf offenen Tabellenformaten – Delta Lake und Apache Iceberg – wodurch eine Anbieterbindung auf der Speicherebene vermieden wird und jede Compute-Engine, die offene Standards unterstützt, auf dieselben Tabellen zugreifen kann.
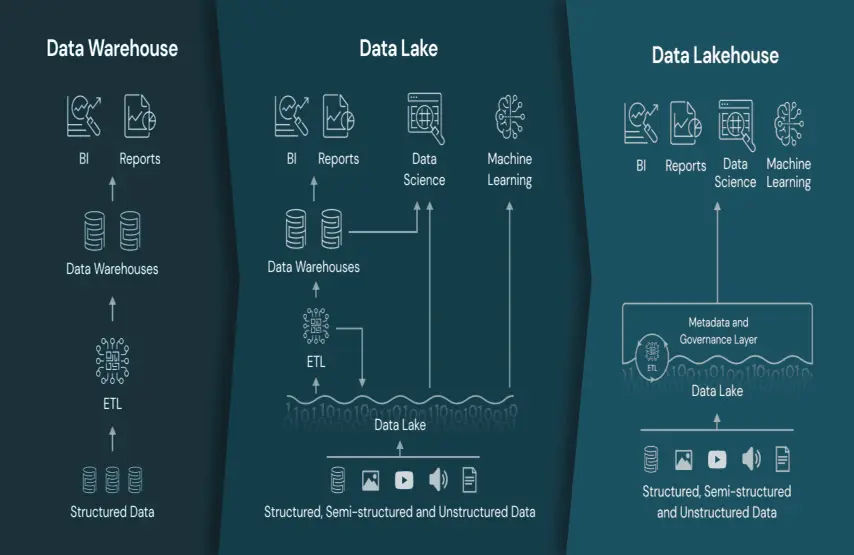 Quelle -Databricks
Wenn Data Warehouse und Data Lake als separate Systeme koexistieren, werden dieselben Daten zweimal erfasst, transformiert und geprüft – von unterschiedlichen Teams, was zu unterschiedlichen Ergebnissen führt. Jede neue Datenquelle vervielfacht diesen Aufwand. Es handelt sich um ein strukturelles Problem, nicht um ein Problem der Datenqualität.
Was macht das Databricks Lakehouse?
Die Lakehouse Databricks-Architektur beseitigt dies von vornherein. Eine einzige offene Plattform – aufgebaut aufDelta-Seeund die Medaillonarchitektur – unterstützt BI-, Streaming- und KI-Workloads auf denselben zugrunde liegenden Daten ohne Verschiebung oder Replikation.
Die Daten durchlaufen die Pipeline-Schichten einmal:
- Bronze —Die Rohdaten werden unverändert und exakt so beibehalten, wie sie von den Quellsystemen stammen.
- Silber —Bereinigt, validiert und angereichert; schemabasiert und qualitätsgeprüft vor jeder analytischen Nutzung
- Gold -aggregiert und optimiert für den jeweiligen Anwendungsfall der Berichterstellung, Dashboard-Erstellung oder des Modelltrainings.
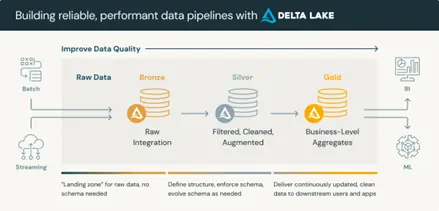
Eine Datenaufnahmepipeline. Eine Transformationslogik. Eine Version der Metrik.
Durch die Eliminierung redundanter Pipelines wird die Fehleranfälligkeit reduziert und die Fehlersuche deutlich vereinfacht. Tritt bei einer Geschäftsprozessanalyse eine Metrikabweichung auf, muss nur noch eine Pipeline untersucht und eine Transformationslogik geprüft werden – nicht mehr drei. Diese Reduzierung der Diagnosekomplexität ist der Punkt, an dem sich die Entwicklungsstunden in produktiven Lakehouse-Umgebungen am zuverlässigsten amortisieren.
Organisationen, die geschichtete Datenarchitekturen mit klar definierten Qualitätssicherungszonen implementieren, berichten von einer dreifachen Verbesserung der Zuverlässigkeit ihrer Datenpipelines im Vergleich zu Organisationen, die flache, unstrukturierte Lake-Architekturen verwenden.
Herkömmliche Data Lakes bieten keine Transaktionsgarantien. Gleichzeitige Schreibvorgänge führen zu unvollständigen Aktualisierungen. Fehlgeschlagene Prozesse hinterlassen Tabellen in undefinierten Zuständen. Schemaänderungen werden unbemerkt weitergegeben und beeinträchtigen nachfolgende Analysen. In regulierten Branchen stellt das Fehlen einer nachvollziehbaren Datenhistorie nicht nur eine technische Unannehmlichkeit, sondern auch ein Compliance-Risiko dar.
Was leistet das Databricks Data Lakehouse?
Delta Lake löst das Transaktionsproblem auf Ebene des Speicherformats. Jeder Schreibvorgang wird entweder vollständig abgeschlossen oder gar nicht ausgeführt – keine Teilzustände, keine stillen Datenbeschädigungen. Die Schemaerzwingung verhindert, dass Änderungen aus vorgelagerten Systemen ohne explizite Validierung in analytische Datensätze übernommen werden. Die Time-Travel-Funktion ermöglicht es Entwicklern, jede frühere Version einer Tabelle abzufragen oder wiederherzustellen – was früher Stunden dauerte, dauert jetzt nur noch Minuten.
Apache Iceberg erweitert diese Garantien durch eine offene Spezifikation auf Multi-Engine-Umgebungen und gewährleistet so, dass unabhängig davon, welche Compute Engine die Tabelle liest oder schreibt, dieselben Transaktionseigenschaften gelten.
Bis 2026 werden 60 % der Organisationen, die ihre Daten nicht auf der Speicherebene kontrollieren, mindestens einen schwerwiegenden Compliance-Vorfall im Zusammenhang mit KI- oder Analyseergebnissen erleben.“
Auswirkungen auf das Geschäft:
Wenn für ein Compliance-Audit die Dokumentation der Datenherkunft erforderlich ist oder eine KI-Initiative einer CISO-Governance-Prüfung unterzogen wird, liefern die Time-Travel- und Lineage-Funktionen der Databricks Data Lakehouse-Architektur strukturierte, abfragefähige Nachweise, die manuelle Dokumentationsprozesse nicht erbringen können. Die Auditvorbereitungszeit verkürzt sich von Tagen auf Stunden – nicht weil sich der Prozess geändert hat, sondern weil die Nachweise in jedem Schritt automatisch erfasst wurden.
In fragmentierten Architekturen wird Governance in jeder Umgebung separat angewendet – Data-Warehouse-Berechtigungen in einem System, Data-Lake-Kontrollen in einem anderen, ML-Zugriffe werden unabhängig verwaltet. Die Datenherkunft lässt sich innerhalb von Umgebungen nachvollziehen, nicht umgebungsübergreifend. Wenn eine KI-Initiative im Rahmen einer CISO-Prüfung gefragt wird, mit welchen Daten das Modell trainiert wurde, wer Zugriff darauf hatte und welche Kontrollen implementiert waren, kann eine unkontrollierte Architektur diese Fragen nicht beantworten. Projekte werden gestoppt.
78% of business executives lack strong confidence that they could pass an independent AI governance audit within 90 days. The governance gap is not a peripheral concern. It is the central obstacle between AI experimentation and AI at scale.
Was macht das Databricks Lakehouse?
Unity-KatalogDie Lakehouse-Plattform bietet eine einheitliche Governance-Ebene für alle Daten, Analysen, ML-Modelle, Notebooks und Dashboards, die in einem Metastore mit konsistenten Zugriffsrichtlinien verwaltet werden. Die Steuerung auf Zeilen- und Spaltenebene erfolgt mittels Standard-ANSI-SQL. Die durchgängige Datenherkunft verfolgt jede Transformation von den Rohdaten über alle Pipeline-Ebenen bis zum finalen Modell oder Bericht – in einem abfragefähigen Graphen.
Der Unity Catalog muss bereitgestellt werden, bevor Pipelines erstellt und Modelle trainiert werden. Die nachträgliche Integration von Governance in ein laufendes System ist deutlich teurer – sowohl hinsichtlich Entwicklungszeit als auch des Vertrauens der Stakeholder – als eine von Anfang an korrekte Architektur.
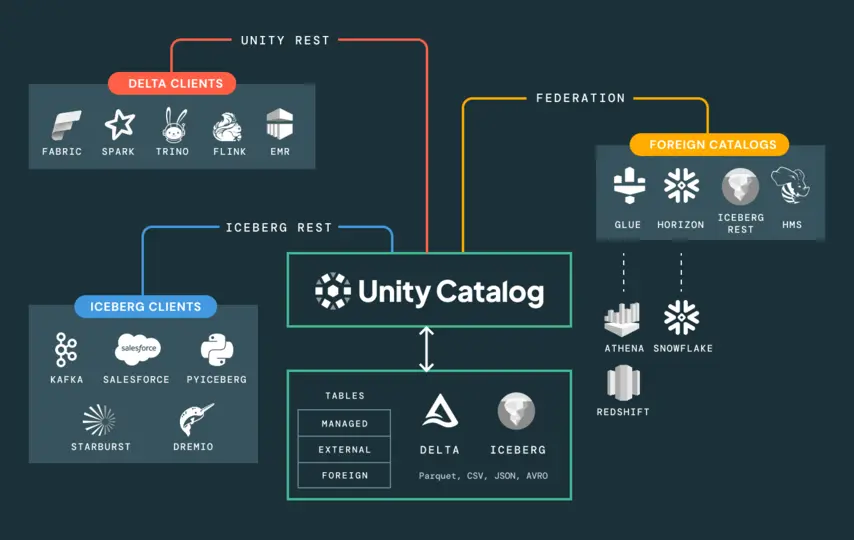 Quelle -Databricks Unity-Katalog
Manuell programmierte Streaming-Pipelines erfordern von den Entwicklern die explizite Pflege jedes Fehlermodus – Checkpoint-Management, Zustandswiederherstellung, Schemaentwicklung, Wiederholungslogik. Bei großem Umfang wird dies zu einer Wartungsbelastung, die die für die Entwicklung neuer Lösungen benötigten Kapazitäten bindet. Pipeline-Fehler sind keine Ausnahmefälle. Sie sind wiederkehrende Ereignisse, auf denen die Rufbereitschaft basiert.
Was macht das Databricks Lakehouse?
Lakeflow Pipelines (formerly Delta Live Tables) inverts the pipeline development model from imperative to declarative. Engineers define what the data should look like and what quality standards it must meet. Lakeflow Pipelines manages dependency resolution, auto-scaling, error handling, retry logic, and data quality enforcement automatically — through configurable expectations that warn, quarantine, or halt on quality violations.
Lakeflow Jobs extends this to multi-step orchestration: scheduling complex pipelines that combine notebooks, Lakeflow pipeline tasks, and ML models, with built-in repair and rerun capabilities that resume from the point of failure rather than restarting from scratch.
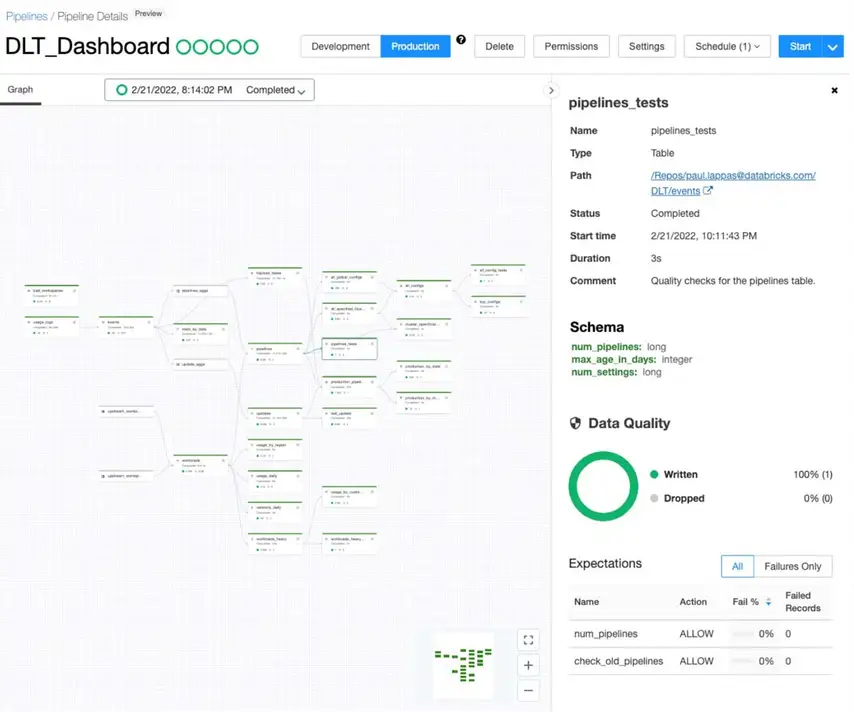 Quelle -Databricks DLT
When a pipeline fails in a Lakeflow Pipelines environment, engineers resolve the upstream cause and resume from the point of failure — the platform handles the rest. In a hand-coded streaming environment, the same failure requires a full diagnostic trace, manual state reconstruction, and a restart from scratch. At scale, that difference in recovery time is where the operational return on declarative Lakehouse architecture is most visible.
Die manuelle Clusterverwaltung führt zu einem anhaltenden Kosten- und Overhead-Problem. Bei einer Dimensionierung für Spitzenlasten zahlt man für ungenutzte Rechenleistung außerhalb der Spitzenzeiten. Bei einer Dimensionierung für durchschnittliche Lasten kommt es in Spitzenzeiten zu Auftragsstaus. Manuelle Optimierungen – VACUUM, OPTIMIZE, Partitionsanpassungen – sind zeitaufwändig und führen zu inkonsistenten Ergebnissen je nach Workload-Typ.
Was macht das Databricks Lakehouse?
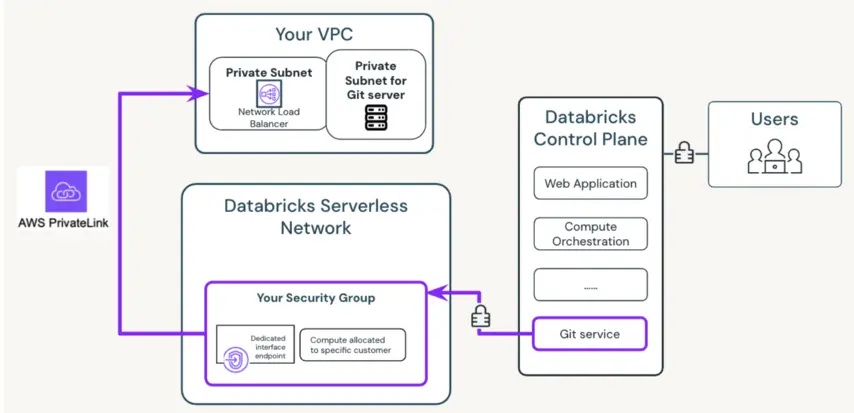
Serverloses Computing auf der Databricks Lakehouse-Plattform abstrahiert die Infrastrukturverwaltung vollständig. Rechenleistung wird sofort bereitgestellt, sobald eine Arbeitslast startet, und wieder freigegeben, sobald sie abgeschlossen ist – ohne Clusterkonfiguration, ohne Verwaltung ungenutzter Ressourcen und ohne Kaltstartverzögerungen. Die Sicherheitsarchitektur trennt die Steuerungsebene von der Datenebene und gewährleistet so, dass Kundendaten im eigenen Cloud-Konto des Kunden verbleiben und sowohl im Ruhezustand als auch während der Übertragung verschlüsselt sind – unabhängig davon, ob die Bereitstellung als AWS Data Lakehouse oder Azure Databricks Lakehouse erfolgt.
Die prädiktive Optimierung schließt den manuellen Optimierungskreislauf: KI-gestützte Algorithmen analysieren kontinuierlich Abfragemuster und führen Hintergrundwartungsarbeiten – VACUUM, OPTIMIZE – nur dann durch, wenn die Leistungsanalyse eine signifikante Verbesserung anzeigt. Manuelle Optimierung wird durch automatisierte, ROI-gerechtfertigte Wartung ersetzt.
Wissen Sie?
Die Databricks Lakehouse-Plattform mit strukturierter Rechengovernance erzielte über drei Jahre einen ROI von 247 % bei einer Amortisationszeit von unter sieben Monaten!
 Quelle -Databricks
Niedrigere Gesamtbetriebskosten, schnellere Workload-Ausführung und konstant hohe Abfrageleistung ohne manuelle Optimierung. Die Entwicklungskapazitäten werden von der Infrastrukturverwaltung auf die Pipeline-Entwicklung umgelenkt – eine Arbeit, deren Wert sich im Laufe der Zeit immer weiter steigert!
Once the architecture is in place, the five challenges above resolve into a set of compounding advantages:
- One pipeline, one version of the truth. A single ingestion pipeline replaces duplicated warehouse and lake logic, so every metric traces back to one transformation rather than three competing ones.
- Reliability built into the storage layer. Delta Lake brings transaction reliability and schema enforcement, and turns audit preparation into a simple query instead of a couple of days of manual work.
- Governance with true end-to-end lineage. Unity Catalog manages data, notebooks, models, and dashboards in a single metastore, giving every function shared lineage and acting as the bridge between the CISO and each stage of an AI initiative.
- Declarative pipelines that run themselves. With Lakeflow Pipelines and Workflows, engineers define the result they want and the platform takes responsibility for scaling, retrying, and recovering from failure.
- Lower cost without losing performance. Serverless compute and Predictive Optimisation automate cluster management and tuning, so overall spend drops while query performance holds steady.
Taken together, these benefits redirect engineering capacity from maintaining fragmented infrastructure to building the pipelines and models that compound in value over time.
The sequencing of implementation decisions determines whether the Databricks Lakehouse architecture delivers or accumulates a new category of technical debt. Provision Unity Catalog first. Enforce compute governance before workloads scale. Adopt Lakeflow Pipelines before manual orchestration becomes the liability your on-call rotation is built around. These decisions are harder to retrofit than to get right from the start — and the cost of getting them wrong shows up quickly in cloud bills, compliance reviews, and engineering morale.
This is precisely where having navigated these decisions across multiple production environments makes the difference.
Polestar Analytics is a certified Databricks consulting partner that helps enterprises build production-grade data, AI, and analytics solutions on Databricks. we built Lakehouse architectures across logistics, manufacturing, and financial services — implementing Unity Catalog governance frameworks, Lakeflow pipeline architectures, and compute policies that hold up under real production pressure. We do not consult from a distance. We have made these calls under deadline, in production, with real stakes.
If your organisation is evaluating the Databricks Lakehouse platform for the first time or trying to unlock more from an existing deployment that has not delivered on its architectural promise — the right starting point is a conversation about where your architecture currently stands and what sequencing makes sense given your data estate, team, and AI roadmap.
- Fragmentation is an architecture problem, not a tooling one. The Lakehouse runs BI, streaming, and AI on one open platform, so data flows once instead of being built and reconciled three times.
- Five challenges, five mechanics: medallion architecture (duplicate pipelines), Delta Lake (reliability), Unity Catalog (governance), Lakeflow Pipelines and Workflows (orchestration), and serverless plus Predictive Optimisation (cost).
- Sequencing decides the outcome. Provision Unity Catalog first, govern compute early, and adopt Lakeflow Pipelines before manual orchestration becomes a liability. These are far harder to retrofit than to get right upfront.
For phased migration projects, the duration usually depends on the size and complexity of the existing data estate. However, the average timeframe is a couple of months to less than one year. Moreover, carrying out a pilot phase with one workload that has high value could help achieve measurable results faster.
Yes. It operates on AWS, Azure, and Google Cloud, so with it, there is no hassle with moving services. That's how you can ensure that all your information stays within your environment and that infrastructure changes aren't disruptive.
Not from scratch. Teams already fluent in SQL, Python, and Spark transfer their skills directly, and the declarative model in Lakeflow Pipelines often reduces the code they maintain. The main shift is conceptual, moving from managing infrastructure to defining outcomes.