


 Kshitij GuptaDatastrateg
Registrera dig för att få de senaste insikterna och uppdateringarna inom teknik, AI och dataanalys, datavetenskap och innovationer från Polestar Analytics.
 Sammanfatta detta blogginlägg med:
| The Databricks Lakehouse unifies warehouse and lake into one open platform, eliminating duplicate pipelines and solving reliability, governance, orchestration, and cost challenges in data engineering. |
TL;DR: Fragmented data stacks are ineffective because their tools are not integrated with one another. To address this problem, Databricks Lakehouse comes into play. Databricks Lakehouse solves five core problems: duplicate pipelines, reliability, governance, orchestration, and cost. Sequencing matters: provision Unity Catalog first, enforce compute governance early, and adopt Lakeflow Pipelines before manual orchestration becomes a liability.
De flesta datatekniska team inom företag misslyckas inte på grund av brist på verktyg. De misslyckas eftersom de verktyg som ackumulerats under det senaste decenniet aldrig var utformade för att fungera tillsammans.
Ett lager för rapportering. En sjö för skalning. En separat ML-miljö. Ett streaminglager som installerades när batchen inte höll jämna steg. Varje beslut var logiskt vid den tidpunkten. Arkitekturen de producerade tillsammans gör det inte.
Vet du?
- Over a quarter of organisations estimate they lose more than $5 million a year to poor data quality, with 7% losing $25 million or more.
- AI spending is forecast to surpass $2 trillion in 2026 at 37% year-over-year growth , and when AI investment scales, the cost of poor data quality scales with it.
The Databricks Lakehouse replaces the fragmented stack with a single open platform. This blog works through the specific data engineering challenges the Databricks data Lakehouse architecture solves — and the mechanics of how it solves them.
~ Bablu Chakraborty, senior vice VD – Kompetens, Polestar Analytics
Innan man undersöker enskilda utmaningar är det värt att vara exakt om vad Databricks Lakehouse-plattformen är – eftersom den definitionen formar varje implementeringsbeslut nedströms.
Databricks data Lakehouse är inte ett lager med tillagda sjöfunktioner, eller en sjö med påbyggd lagerstyrning. Det är en enda öppen plattform som tillhandahåller transaktionell tillförlitlighet, schematillämpning och frågeprestanda för ett lager samtidigt som skalan, öppenheten och ML-kompatibiliteten hos en datasjö bibehålls. Lakehouse-arkitekturen på Databricks körs på öppna tabellformat – Delta Lake och Apache Iceberg – vilket innebär att det inte finns någon leverantörslåsning på lagringslagret, och varje beräkningsmotor som stöder öppna standarder kan läsa från och skriva till samma tabeller.
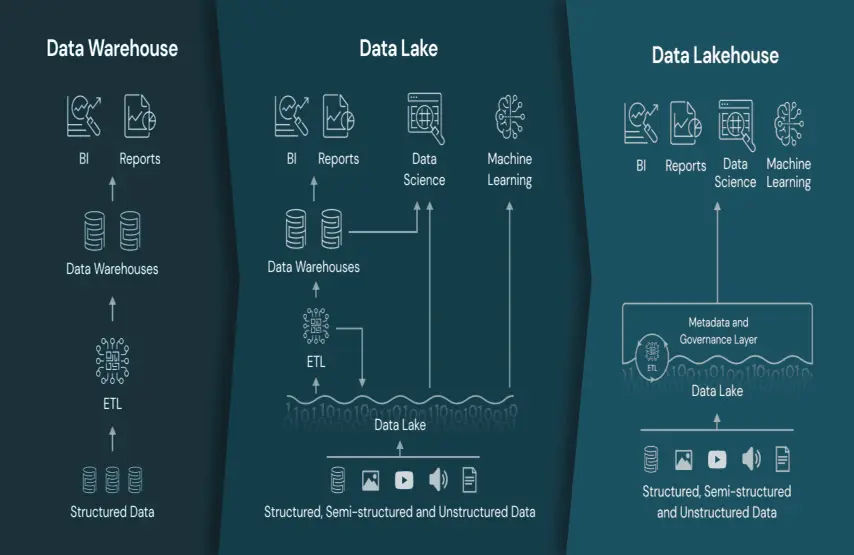
När ett lager och en datasjö samexisterar som separata system, matas samma data in två gånger, transformeras två gånger och kvalitetskontrolleras två gånger – av olika team, vilket producerar olika siffror. Varje ny datakälla multiplicerar denna omkostnad. Det är ett strukturellt problem, inte ett problem med datakvalitet.
Lakehouse Databricks-arkitekturen eliminerar detta genom sin design. En enda öppen plattform – byggd påDeltasjönoch medaljongarkitekturen – stöder BI-, streaming- och AI-arbetsbelastningar på samma underliggande data utan förflyttning eller replikering.
Data flödar en gång genom pipeline-lagren:
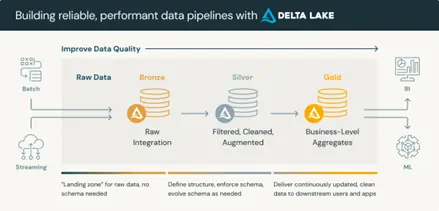
En inmatningspipeline. En transformationslogik. En version av måttet.
FoundationStudio puts this layering into practice: it drafts the governed medallion layers from your KPI catalogue and pushes the SQL to your Git repository, with people approving what the AI proposes.
Elimineringen av dubbla pipelines minskar felytan och förenklar felsökning avsevärt. När en metrisk avvikelse uppstår i en verksamhetsgranskning finns det en pipeline att undersöka och en transformationslogik att granska – inte tre. Det är den minskningen av diagnostisk komplexitet som gör att ingenjörstimmar återvinns mest konsekvent i produktionsmiljöer i Lakehouse.
Organisationer som implementerar skiktade dataarkitekturer med tydliga kvalitetskontrollzoner rapporterar en 3 gånger förbättring av tillförlitligheten i datapipelines jämfört med de som använder platta, ostrukturerade sjöarkitekturer.
Traditionella datasjöar saknar transaktionsgarantier. Samtidiga skrivningar producerar partiella uppdateringar. Misslyckade jobb lämnar tabeller i obestämda tillstånd. Schemaändringar sprids tyst och korrumperar analyser nedströms. I reglerade branscher är avsaknaden av en granskbar datahistorik en efterlevnadsrisk, inte bara en teknisk olägenhet.
Delta Lake löser transaktionsproblemet på lagringsformatnivå. Varje skrivning antingen slutförs helt eller sker inte alls – inga partiella tillstånd, ingen tyst korruption. Schematillämpning förhindrar att uppströmsändringar sprids till analytiska datamängder utan explicit validering på pipeline-lagret. Tidsresor gör det möjligt för ingenjörer att fråga eller återställa vilken tidigare version av en tabell som helst – det som tidigare tog timmar tar minuter.
Apache Iceberg utökar dessa garantier till miljöer med flera motorer genom en öppen specifikation, vilket säkerställer att samma transaktionella egenskaper gäller oavsett vilken beräkningsmotor som läser eller skriver tabellen.
År 2026 kommer 60 % av organisationer som inte hanterar sina data på lagringslagret att uppleva minst en väsentlig efterlevnadsincident relaterad till AI- eller analysresultat.
När en efterlevnadsrevision kräver dokumentation av dataproveniens, eller när ett AI-initiativ träffar en CISO-styrningsgranskning, ger tidsrese- och härkomstfunktionerna i Databricks data Lakehouse-arkitektur strukturerade, frågebara bevis som manuella dokumentationsprocesser inte kan. Förberedelsetiden för revisioner minskar från dagar till timmar – inte för att processen ändrades, utan för att bevisen samlades in automatiskt i varje steg.
I fragmenterade arkitekturer tillämpas styrning separat i varje miljö – lagerbehörigheter i ett system, sjökontroller i ett annat, ML-åtkomst hanteras oberoende. Härstamningsspårning inom miljöer, inte mellan dem. När ett AI-initiativ träffar en CISO-granskning som frågar vilka data modellen tränade på, vem som hade åtkomst och vilka kontroller som fanns på plats – kan en ostyrd arkitektur inte svara på det. Projekten stannar av.
78% of business executives lack strong confidence that they could pass an independent AI governance audit within 90 days. The governance gap is not a peripheral concern. It is the central obstacle between AI experimentation and AI at scale.
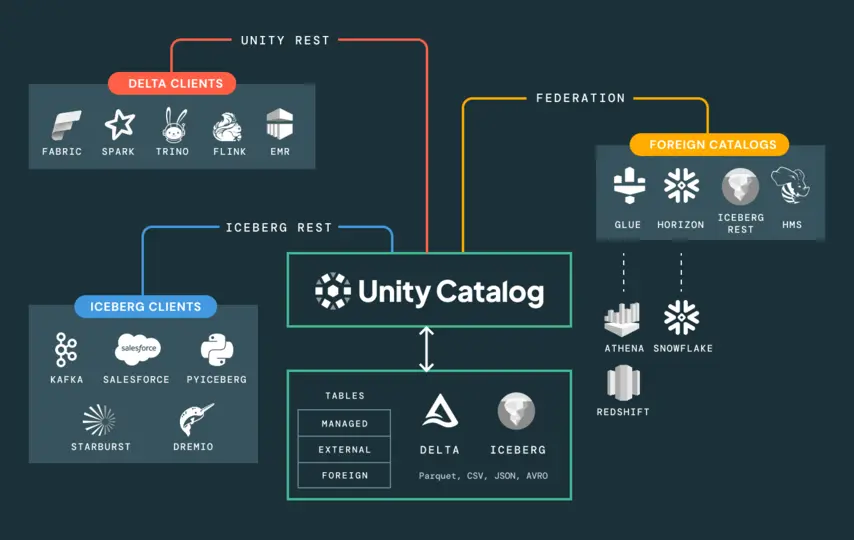
Unity-katalogentillhandahåller ett enda styrningslager över hela Lakehouse-plattformen – data, analyser, ML-modeller, anteckningsböcker och instrumentpaneler som hanteras under en metaarkiv med konsekventa åtkomstpolicyer. Kontroller på rad- och kolumnnivå tillämpas med standard ANSI SQL. End-to-end-avstamning spårar varje transformation från råkälla genom varje pipeline-lager till den slutliga modellen eller rapportutdata – i ett frågbart diagram.
Unity Catalog måste etableras innan pipelines byggs och innan modeller tränas. Att eftermontera styrning i ett fungerande system kostar betydligt mer – i form av ingenjörstid och intressenternas förtroende – än att utforma det korrekt från början.
Handkodade strömmande pipelines kräver att ingenjörer explicit underhåller varje felläge – kontrollpunktshantering, tillståndsåterställning, schemautveckling, logik för återförsök. I stor skala blir detta en underhållsskyldighet som förbrukar den kapacitet som behövs för att bygga något nytt. Pipelinefel är inte edge-fall. De är de återkommande händelser som jourrotationer byggs kring.
Lakeflow Pipelines (formerly Delta Live Tables) inverts the pipeline development model from imperative to declarative. Engineers define what the data should look like and what quality standards it must meet. Lakeflow Pipelines manages dependency resolution, auto-scaling, error handling, retry logic, and data quality enforcement automatically — through configurable expectations that warn, quarantine, or halt on quality violations.
Lakeflow Jobs extends this to multi-step orchestration: scheduling complex pipelines that combine notebooks, Lakeflow pipeline tasks, and ML models, with built-in repair and rerun capabilities that resume from the point of failure rather than restarting from scratch.
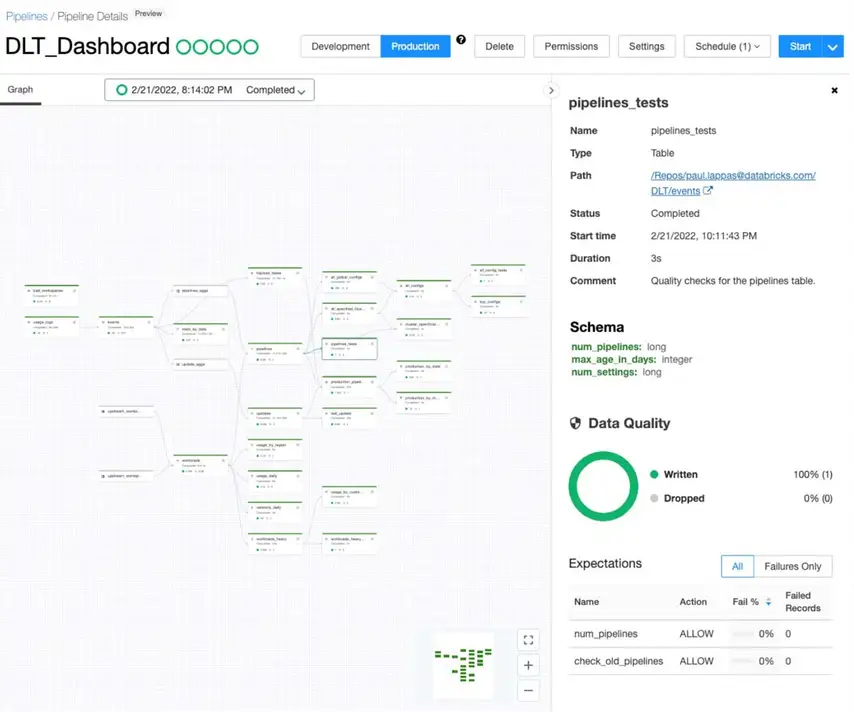
When a pipeline fails in a Lakeflow Pipelines environment, engineers resolve the upstream cause and resume from the point of failure — the platform handles the rest. In a hand-coded streaming environment, the same failure requires a full diagnostic trace, manual state reconstruction, and a restart from scratch. At scale, that difference in recovery time is where the operational return on declarative Lakehouse architecture is most visible.
Manuell klusterhantering skapar ett ihållande kostnads- och omkostnaderproblem. Storlek för toppbelastning och du betalar för inaktiv beräkning vid lågtrafik. Storlek för genomsnitt och jobbkö vid toppar. Manuell finjustering – VACUUM, OPTIMIZE, partitionsjusteringar – är tidskrävande och inkonsekvent mellan olika arbetsbelastningstyper.
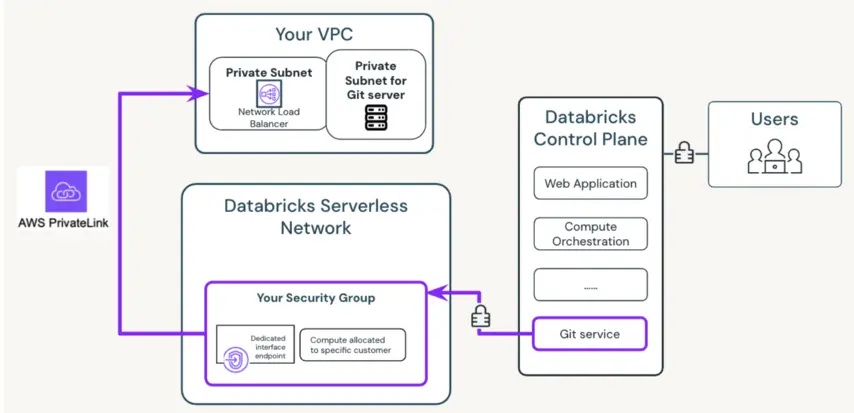
Serverlös beräkning på Databricks Lakehouse-plattformen abstraherar infrastrukturhanteringen helt. Beräkningen provisioneras direkt när en arbetsbelastning startar och släpps när den är klar – ingen klusterkonfiguration, ingen hantering av inaktiva resurser, inga kallstartsfördröjningar. Säkerhetsarkitekturen separerar kontrollplanet från dataplanet, vilket säkerställer att kunddata finns kvar i kundens eget molnkonto, krypterade i vila och under överföring – oavsett om de distribueras som ett AWS Data Lakehouse eller ett Azure Databricks Lakehouse.
Prediktiv optimering stänger den manuella justeringsslingan: AI-drivna algoritmer analyserar frågemönster kontinuerligt och kör bakgrundsunderhåll – VACUUM, OPTIMIZE – endast när prestandaanalyser indikerar en meningsfull förbättring. Manuell justering ersätts av automatiserat, ROI-motiverat underhåll.
Vet du?
Databricks Lakehouse-plattform med strukturerad beräkningsstyrning uppnådde en avkastning på investeringen på 247 % under tre år, med en återbetalningstid på under sju månader!
Lägre total ägandekostnad, snabbare arbetsbelastningskörning och konsekvent hög frågeprestanda utan manuell finjustering. Ingenjörskapacitet omdirigeras från infrastrukturhantering till pipelineutveckling – det arbete som ökar i värde över tid!
Once the architecture is in place, the five challenges above resolve into a set of compounding advantages:
Taken together, these benefits redirect engineering capacity from maintaining fragmented infrastructure to building the pipelines and models that compound in value over time.
The sequencing of databricks implementation decisions determines whether the Databricks Lakehouse architecture delivers or accumulates a new category of technical debt. Provision Unity Catalog first. Enforce compute governance before workloads scale. Adopt Lakeflow Pipelines before manual orchestration becomes the liability your on-call rotation is built around. These decisions are harder to retrofit than to get right from the start — and the cost of getting them wrong shows up quickly in cloud bills, compliance reviews, and engineering morale.
This is precisely where having navigated these decisions across multiple production environments makes the difference. Polestar Analytics is a certified Databricks consulting partner that helps enterprises build production-grade data, AI, and analytics solutions on Databricks. we built Lakehouse architectures across logistics, manufacturing, and financial services — implementing Unity Catalog governance frameworks, Lakeflow pipeline architectures, and compute policies that hold up under real production pressure. We do not consult from a distance. We have made these calls under deadline, in production, with real stakes.
If your organisation is evaluating the Databricks Lakehouse platform for the first time or trying to unlock more from an existing deployment that has not delivered on its architectural promise — the right starting point is a conversation about where your architecture currently stands and what sequencing makes sense given your data estate, team, and AI roadmap.
For phased migration projects, the duration usually depends on the size and complexity of the existing data estate. However, the average timeframe is a couple of months to less than one year. Moreover, carrying out a pilot phase with one workload that has high value could help achieve measurable results faster.
Yes. It operates on AWS, Azure, and Google Cloud, so with it, there is no hassle with moving services. That's how you can ensure that all your information stays within your environment and that infrastructure changes aren't disruptive.
Not from scratch. Teams already fluent in SQL, Python, and Spark transfer their skills directly, and the declarative model in Lakeflow Pipelines often reduces the code they maintain. The main shift is conceptual, moving from managing infrastructure to defining outcomes.
Om författaren
Datastrateg
De flesta data besvarar frågor. Rätt data ändrar riktning.
Relaterad blogg
 Astha Chadha
Kshitij Gupta