
Sammanfatta detta blogginlägg med:
TL;DR:AWS och Databricks utbyter tjänster som är löst kopplade till en enhetlig Lakehouse-plattform byggd på Delta Lake ochUnity-katalogenAWS to Fabric ersätter detsamma med OneLake som en delad grund. Med Snowflake to Fabric, eftersom du redan använder en konsoliderad plattform, är det verkliga beslutet om lagret förblir i centrum eller om Fabrics bredare delade utrymme tar över.
Agent AI-arbetsbelastningarkommer att utlösa hundratals åtgärder från en enda prompt, vilket skapar massiva krav på data, beräkning och lagring. Agenter kommer kontinuerligt att fråga, resonera kring och agera utifrån det, vilket ställer nya krav på beräkning, lagring, integration, styrning och datatillgänglighet.
Det här betyder att äldre dataarkitekturer kämpar för att hantera denna skala effektivt, vilket leder till högre infrastrukturkostnader och driftskomplexitet. Så,modernisera och migrera datatillgångenär avgörande för att stödja skalbara, kostnadseffektiva AI-arbetsbelastningar, vilket 83 % tror på. Om inte, medför de äldre strukturerna latens, dubbelarbete, integrationskostnader och stigande infrastrukturkostnader.
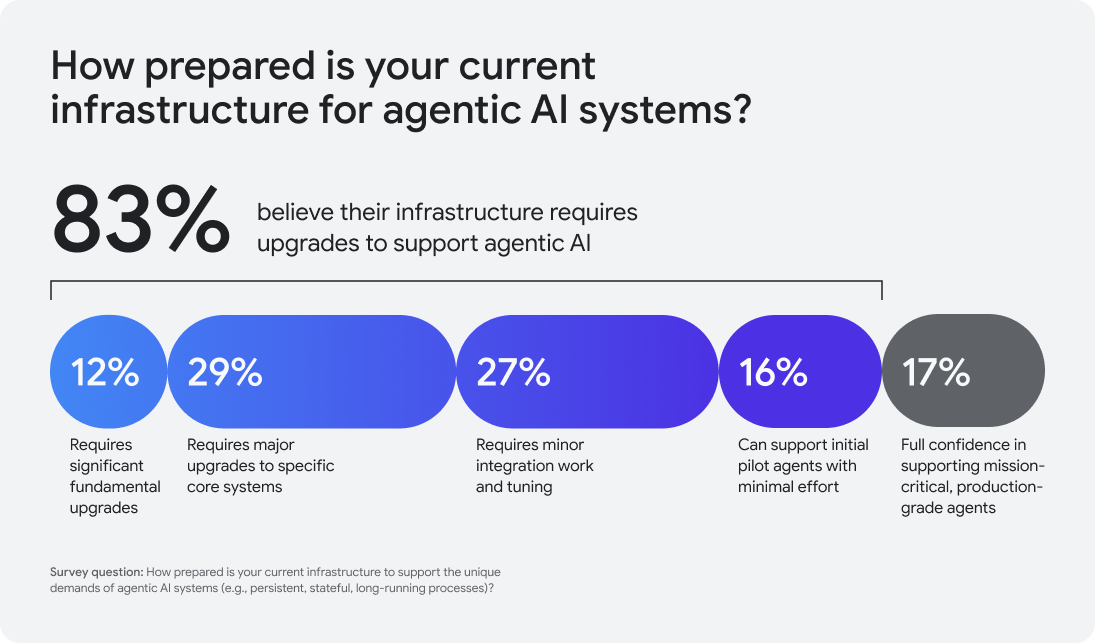 Källa:Google, rapport om tillståndet för AI-infrastruktur
Svaret på detta problem börjar med molnmigrering ellermigrering av datatillgångarMen att flytta data från en plattform till en annan handlar inte bara om att kopiera tabeller och bygga om pipelines.Arkitekturen under förändras.Lagringslager, beräkningsmotorer, dataformat, orkestrering, säkerhet, styrning, semantiska modeller och arbetsbelastningar kan alla behöva omprövas.
Så, vad vi försöker få med detta är att fördjupa oss i dataplattformsmigreringarna avAWS till Databricks, AWS till Microsoft Fabric eller Snowflake till Fabric— att förstå vad som omplattformas, vad som omdesignas och vad som kan föras vidare.
På en hög nivå:
| Utgångspunkt |
Mål |
Det som förändras mest |
| AWS |
Databricks |
AWS-tjänster konsolideras till en sjöhusorienterad plattform |
| AWS |
Tyg |
AWS-tjänster går mot en OneLake-centrerad analysverksamhet |
| Snöflinga |
Tyg |
Lagercentrerad analys går mot en bredare delad dataplattform |
Ett moget AWS-ekosystem eller en datatillgång kan innefatta S3, Glue, EMR, Redshift, Lambda, Kinesis, Step Functions och extern orkestrering. Snowflake är en starkt integrerad analysplattform, så migreringen till Fabric innebär mindre tjänstekonsolidering och mer omprövning av var lagring, beräkning, teknik, BI och styrning ska placeras. Databricks och Fabric strävar båda efter att minska arkitekturfragmentering, men de gör det på olika sätt.
Så att förstå applikationsberoenden och bedöma teknisk genomförbarhet är två av de viktigaste områdena och även de två största migreringsutmaningarna generellt.
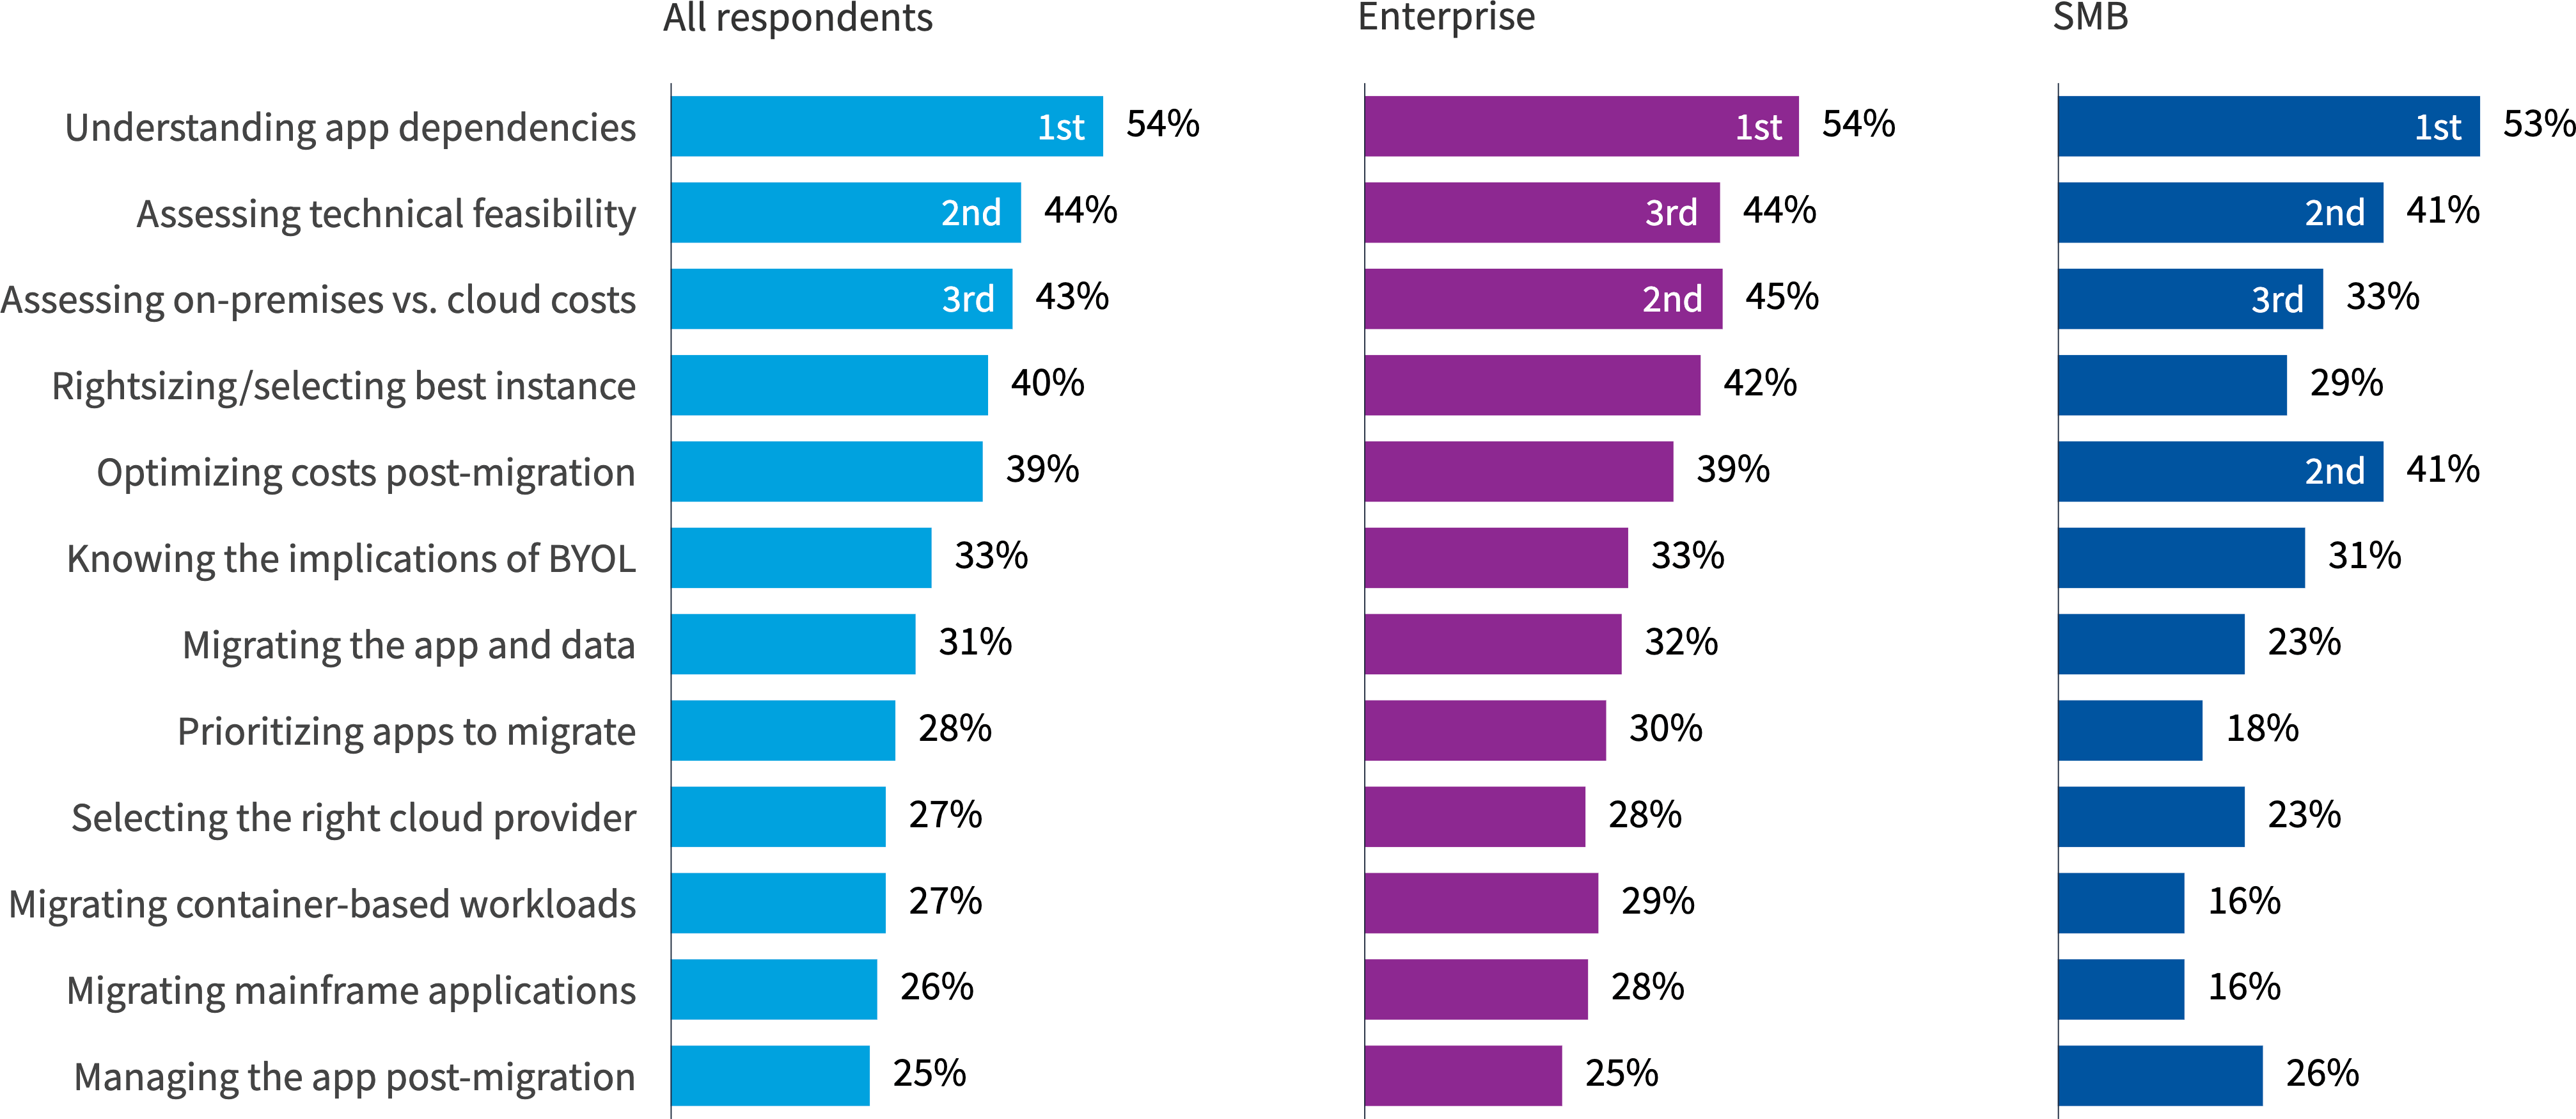 Källa:Flexera 2026 rapport om molnets tillstånd
Låt oss dyka djupare in i var och en av dem.
En migrering från AWS till Databricks ersätter tjänstorkestrering med plattformsorkestrering. S3, Glue, EMR och Redshift har var och en sin egen konfiguration, sina egna behörigheter och fellägen. Databricks konsoliderar alltså den ytan till Delta Lake som transaktionstabelllager, Spark/SQL som delad beräkningsmotor och Unity Catalog som styrningslager, så samma funktion som tidigare krävde fyra tjänster finns nu på en plattform.
Det betyder att du bör börja med att förstå:
- Limjobb och crawlers
- Rödförskjutningsscheman och procedurer
- EMR-arbetsbelastningar
- Stegfunktioner
- Lambdafunktioner
- S3-sökvägar och beroenden
- Strömmande pipelines
- Externa schemaläggare
- Nedströmskonsumenter
Vanligaste frågorna om migrering från AWS till Databricks:
1. Vad händer med AWS Glue ETL-jobb?
Glue-jobb kan migreras till Databricks, men de behöver ofta omdesign av arkitekturen snarare än en enkel kodomskrivning. Glue-arbetsbelastningar med DynamicFrames, crawlers och triggers kan omarbetas kring Spark, Delta Lake och Databricks-nativ orkestrering.
I stället för:Lim → S3 → Rödförskjutning → Lambda
arkitekturen kan bli:Inmatning → Delta Lake → Spark/SQL → Arbetsflöden → BI/ML
Den största fördelen är färre överlämningar mellan tjänster och en mer enhetlig dataplattform.
2. Hur förändras strömning i Databricks?
Strömmande data blir en del av samma Lakehouse-arkitektur snarare än ett separat pipeline-lager. En AWS-pipeline som använder Kinesis, Lambda, S3 och Redshift kan röra sig mot:
Automatisk lastare → Delta Lake → Lakeflow deklarativa rörledningar
Detta gör att batch och streaming kan dela gemensamma mönster, bädda in datakvalitet i pipelines och låta BI, analys och ML konsumera samma styrda datalager.
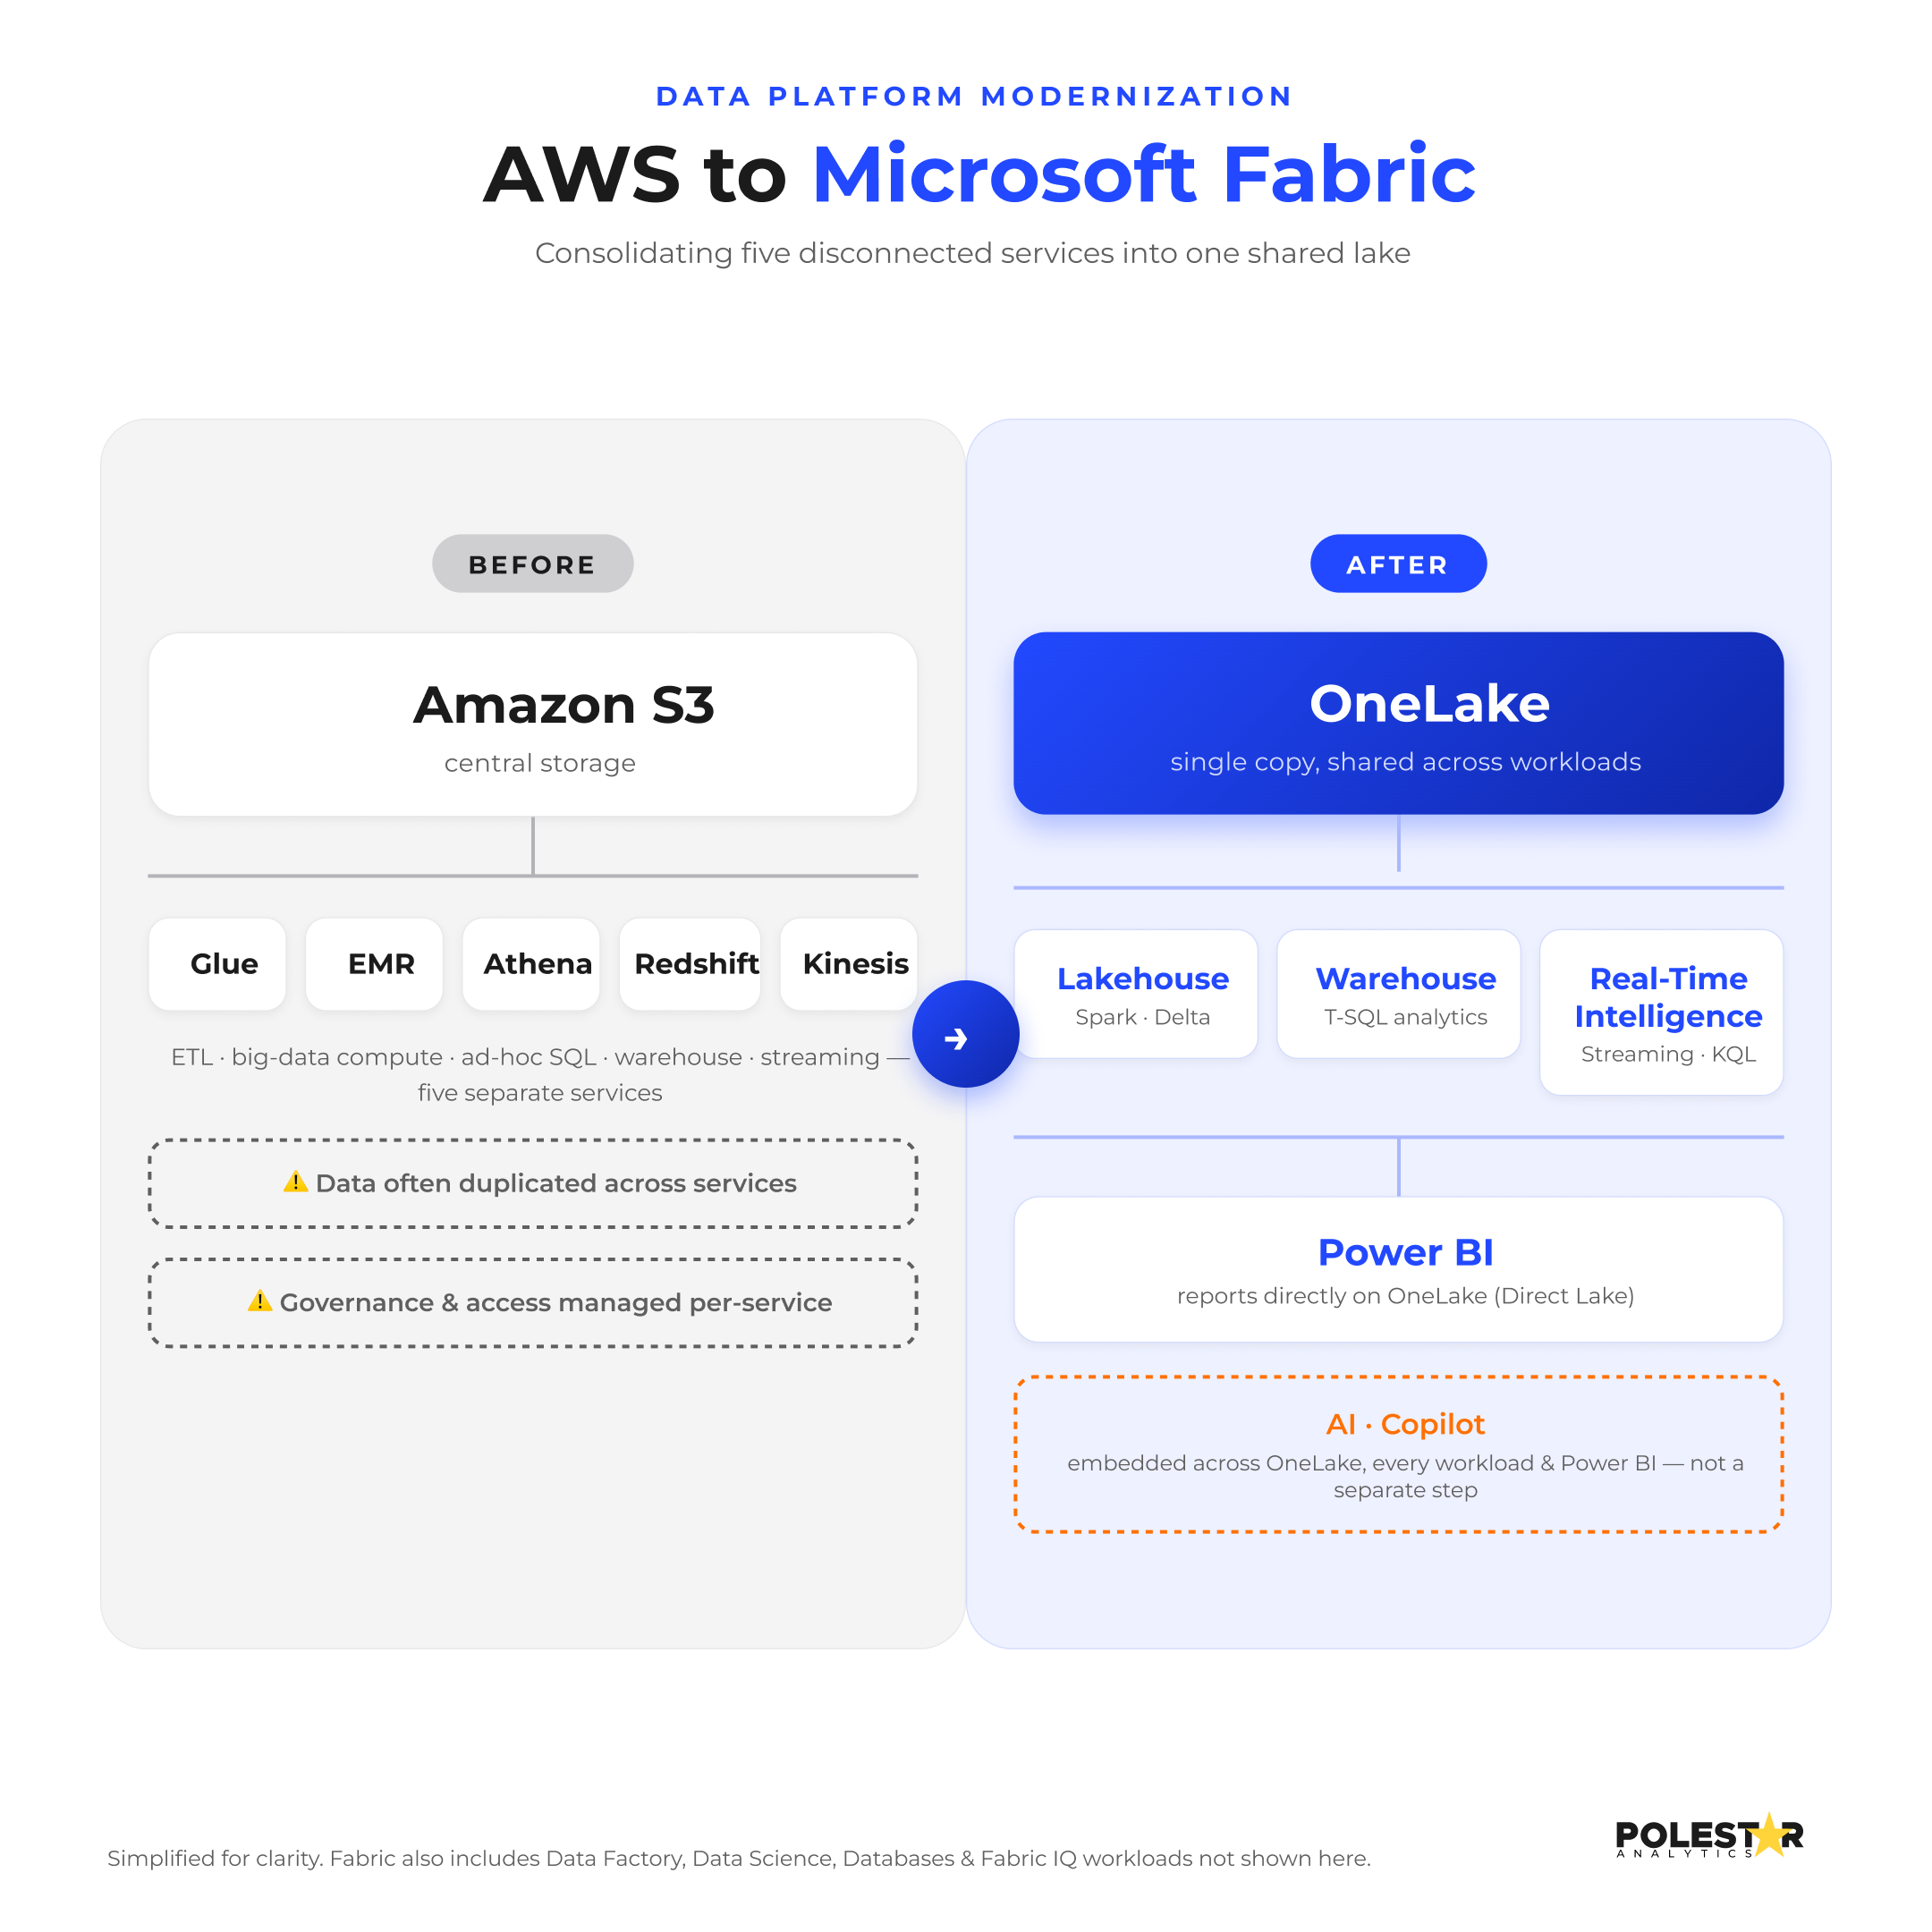
En AWS-to-Fabric-migrering ersätter en fragmenterad tjänstestack med OneLake som delad grund, och till skillnad från Databricks behöver du inte flytta data först.Fabric stöder genvägar till externa källor, inklusive S3-kompatibel lagring, så att team kan ansluta och validera innan de fysiskt flyttar en enda byte.
Det centrala skiftet är mot OneLake. Fabric är utformat kring en delad databas där dess olika arbetsbelastningar kan fungera över samma underliggande data snarare än att varje motor måste underhålla sin egen kopia.
Vanligaste frågorna om migrering av AWS till Fabric:
1. Varför är pipelines ofta svårare att migrera än data?
För att flytta data inte flyttar logiken som är byggd kring den.AWS-arbetsbelastningar kan inkludera limjobb, stegfunktioner, lambdafunktioner, IAM-policyer, datakvalitetsregler, scheman och nedströmsberoenden – som alla måste bedömas separat.
Vissa arbetsbelastningar kan bliPipelines för Fabric Data Factory, andra kan ersättas eller elimineras, och vissa kan finnas kvar utanför Fabric.
Målet är inte attåterskapa AWS inuti FabricDet handlar om att omforma arbetsbelastningsarkitekturen kring vad Fabric kan göra bäst.
2. Hur mappas AWS Kinesis- och Lambda-arbetsbelastningar till Fabric?
Kinesisströmmar kan mappas tillFabric-händelseströmmar och realtidsinformationför händelseinmatning, bearbetning och övervakning, medan Lambda-funktioner kan ersättas avFabric-pipelines, anteckningsböcker eller andra händelsedrivna bearbetningsmönster, beroende på arbetsbelastningen.
AWS: Kinesis → Lambda → S3/Rödförskjutning → nedströmsapplikationer
Tyg: Händelseströmmar → Realtidsinformation / OneLake → Analys och nedströmsarbetsbelastningar
Detta kan minska antalet tjänster som ingår samtidigt somrealtidsinmatning, transformation, lagring och analys på en mer enhetlig plattform.
Denna migrering utgår från en mycket mer konsoliderad arkitektur än de två AWS-scenarierna ovan, vilket gör det frestande att behandla det som en ren SQL-kompatibilitetsövning. Det är för snävt. Den djupare frågan är om lagret ska förbli tyngdpunkten.
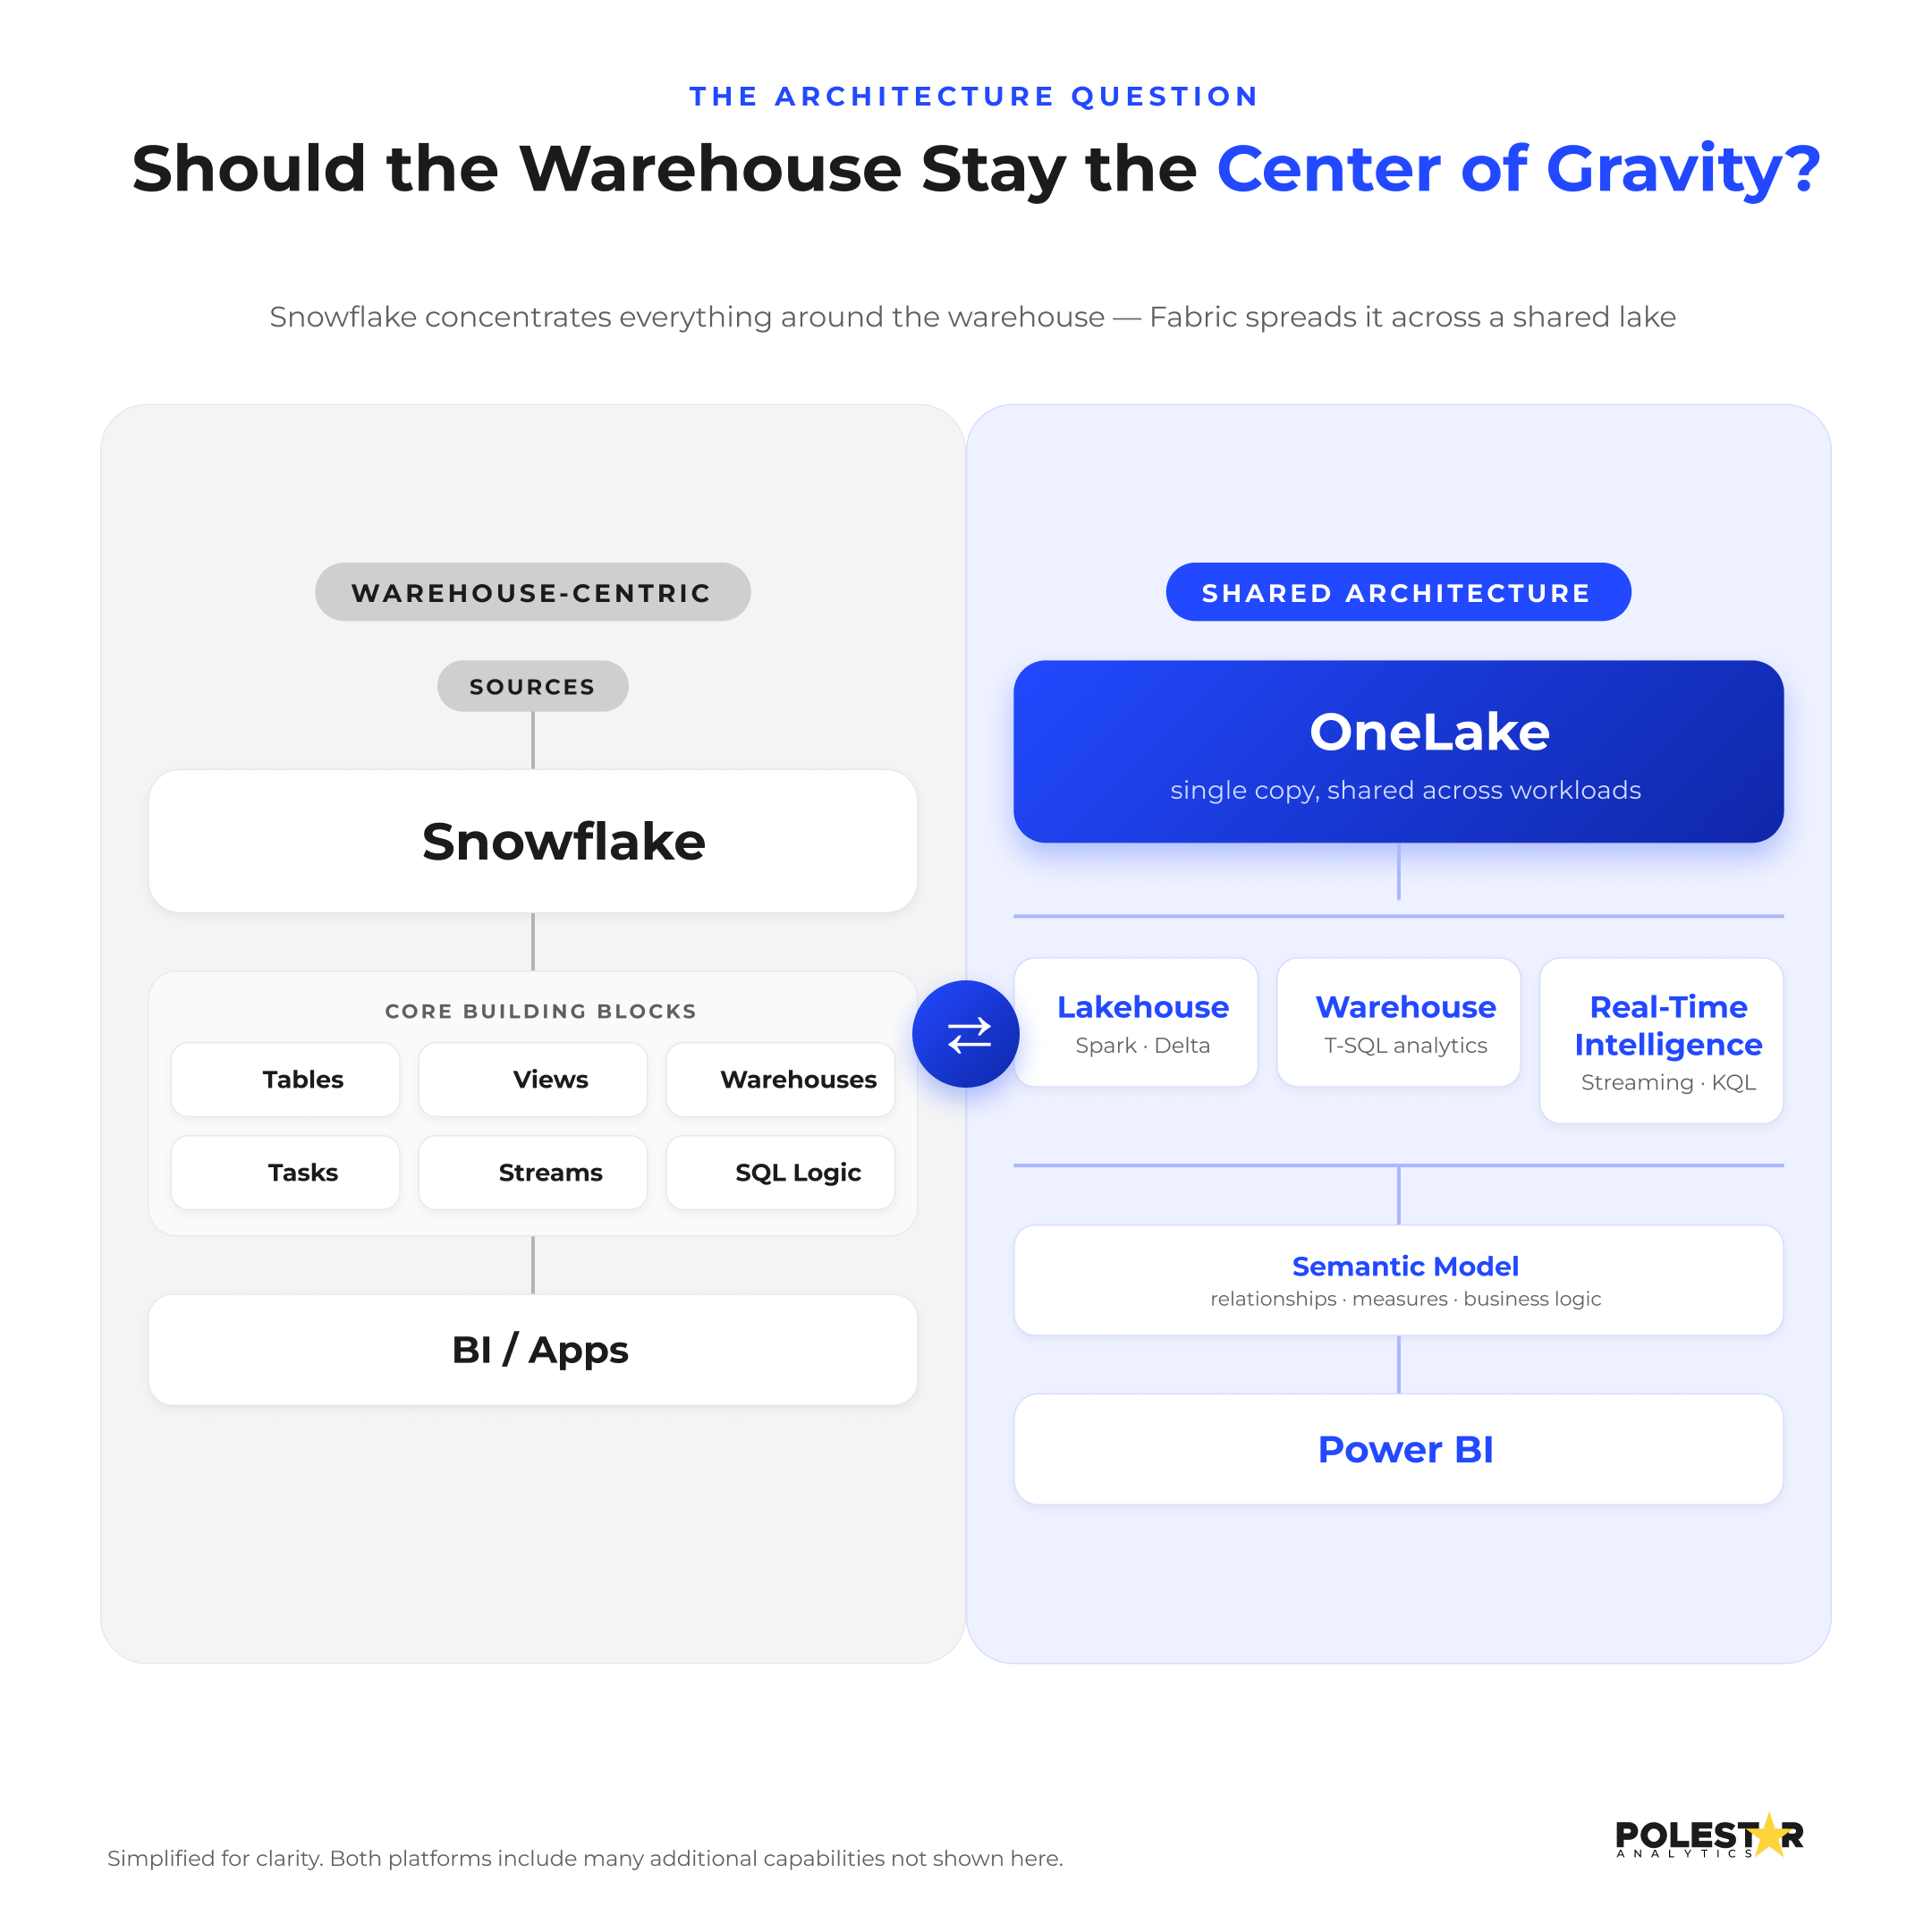
Fördelen med denna datalagermigrering är att det finnsMicrosofts spegling för Snowflake, nu allmänt tillgänglig(bekräftad avMicrosofts GA-meddelande), som kontinuerligt replikerar stödda Snowflake-data till OneLake.Detta skapar en samexistensmodell där befintliga arbetsbelastningar kan fortsätta att fungera medan nya arbetsbelastningar successivt byggs på Fabric. Anledningen till att detta är mer värdefullt än en Big Bang-migrering är att det separerar datamigrering från modernisering av arbetsbelastningar.
Vanliga frågor och svar om migrering från Snowflake till Microsoft Fabric:
1. Hur förändras Snowflakes separation av lagring och beräkning i Microsoft Fabric?
Den underliggande arkitekturen förändras avsevärt.Snowflake separerar lagring och beräkning genom sin virtuella lagermodell, medan Fabric samlar data i OneLake och tillhandahåller arbetsbelastningsspecifik beräkning över sina tjänster.
Det här innebär att migrering kräver granskning av beräkningsstorlek, samtidighet i arbetsbelastning, dataförflyttning, cachning och prestandamönster snarare än att bara flytta tabeller och behålla samma arkitektur.
2. Vad händer med Snowflake-strömmar, uppgifter och schemalagda arbetsbelastningar?
De måste mappas till Fabrics orkestrerings- och databehandlingsfunktioner.Snöflingeuppgifter och strömmar kan översättas tillTygdatafabrikenpipelines, anteckningsböcker eller andra stegvisa bearbetningsmönster, beroende på arbetsbelastningen.
Migreringen är därför en möjlighet att förenkla orkestrering och minska duplicerad dataförflyttning – inte bara reproducera varje Snowflake-uppgift i Fabric.
En vanlig metod för migrering av datalager ser ut så här:
| Gammal |
Ny |
| S3 |
OneLake |
| Lim |
Tygdatafabriken |
| Rödförskjutning |
Tyglager |
| Lambda |
Tygmotsvarighet |
| Stegfunktioner |
Tygrörledningar |
Den tabellen är användbar, men det är inte en arkitektur, eftersom den antar att varje gammal komponent förtjänar en ny komponent. En bättre metod ställer en annan fråga till varje komponent:
| Befintlig arbetsbelastning |
Fråga detta först |
| S3-data |
Behöver den flyttas, eller kan den refereras? |
| Limjobb |
Måste omvandlingen fortfarande finnas kvar? |
| Rödförskjutningstabellen |
Duplicerar det sjödata? |
| Lambda |
Är det databehandling, orkestrering eller applikationslogik? |
| Stegfunktion |
Vilka beroenden är fortfarande verkliga? |
| Snöflingelager |
Hör arbetsbelastningen hemma i ett lager, ett sjöhus eller båda? |
| BI-extrakt |
Kan det semantiska lagret komma åt den delade datan direkt? |
Målarkitekturen bör utformas utifrån affärsmöjligheter, inte rekonstrueras från tekniska artefakter.
MigrationStudio flyttar datalager från en plattform till en annan: AWS till Databricks, AWS till Fabric, Snowflake till Fabric, GCP till Fabric, GCP till Databricks, i princip any-to-any. Det producerar de repeterbara 70 % av det arbetet: ett agentdrivet arbetsflöde som skannar källsystemet, tar reda på vilka jobb som faktiskt körs respektive är föräldralösa, modellerar målarkitekturen, konverterar jobben, optimerar dem och marknadsför resultatet via Git.
Den viktigaste skillnaden är semantisk omplattformning istället för translitterering. De flesta migreringsverktyg mappar gammal syntax till ny syntax och levererar kod som fortfarande tänker som källsystemet, det en-till-en-mappningsmisstag som den här artikeln fortsätter att varnar för. MigrationStudio räknar ut vad ett jobb faktiskt är tänkt att göra, skriver sedan idiomatisk kod för målplattformen och rensar upp skulden längs vägen istället för att kopiera den framåt.
Anspråket är any-to-any, och omfattar AWS till Databricks, AWS till Fabric, Snowflake till Fabric, GCP till Fabric och GCP till Databricks.Där det är tillämpligt är det en minskning av migreringstid och -kostnad med 35 % eller mer jämfört med en manuell ombyggnad.
| Dimensionera |
AWS till Databricks |
AWS till tyg |
Snöflinga till tyg |
| Startar arkitektur |
Distribuerade tjänster |
Distribuerade tjänster |
Integrerad lagerplattform |
| Kärnskifte |
AWS-tjänster till Lakehouse |
AWS-tjänster till OneLake-centrerad plattform |
Från lager till delad datatillgång |
| Lagring |
S3 + Delta |
OneLake + externa genvägar/inmatning |
OneLake via migrerings-/speglings-/lagringsmönster |
| Bearbetning |
Spark + SQL |
Tygmotorer + Spark |
Tyglager/Lakehouse/Spark |
| ETL |
Refaktorera till Lakehouse-nativa pipelines |
Konsolidera till Fabric-pipelines/arbetsbelastningar |
Ompröva lager-ETL kontra Lakehouse-transformation |
| Orkestrering |
Databricks-arbetsflöden/pipelines |
Tygdatafabriken |
Tygorkestrering |
| Styrning |
Unity-katalogen |
Styrning av Fabric/OneLake |
Styrning av Fabric/OneLake |
| Största migrationsrisken |
Återskapa AWS-arkitekturen i Databricks |
Behandla Fabric som en destination istället för en målarkitektur |
Behandla migrering som enbart en SQL-konvertering |
| Största möjligheten |
Förena data + AI-arbetsbelastningar |
Minska plattformsfragmenteringen |
Bredda analyser bortom lagercentrerad arkitektur |