
Vat dit blogbericht samen met:
| The Databricks Lakehouse unifies warehouse and lake into one open platform, eliminating duplicate pipelines and solving reliability, governance, orchestration, and cost challenges in data engineering. |
TL;DR: Fragmented data stacks are ineffective because their tools are not integrated with one another. To address this problem, Databricks Lakehouse comes into play. Databricks Lakehouse solves five core problems: duplicate pipelines, reliability, governance, orchestration, and cost. Sequencing matters: provision Unity Catalog first, enforce compute governance early, and adopt Lakeflow Pipelines before manual orchestration becomes a liability.
De meeste data-engineeringteams binnen bedrijven falen niet door een gebrek aan tools. Ze falen omdat de tools die de afgelopen tien jaar zijn verzameld, nooit ontworpen waren om samen te werken.
Een datawarehouse voor rapportage. Een datameer voor schaalvergroting. Een aparte machine learning-omgeving. Een streaminglaag die werd toegevoegd toen batchverwerking de vraag niet meer aankon. Elk van deze beslissingen was op dat moment logisch. De architectuur die ze samen hebben gecreëerd, is dat niet.
Weet je dat?
- Over a quarter of organisations estimate they lose more than $5 million a year to poor data quality, with 7% losing $25 million or more.
- AI spending is forecast to surpass $2 trillion in 2026 at 37% year-over-year growth , and when AI investment scales, the cost of poor data quality scales with it.
Databricks Lakehouse vervangt de gefragmenteerde architectuur door één open platform. Deze blog bespreekt de specifieke data-engineeringuitdagingen die de Databricks Lakehouse-architectuur oplost, en de mechanismen waarmee dit gebeurt.
Voordat we de individuele uitdagingen bekijken, is het belangrijk om precies te definiëren wat het Databricks Lakehouse-platform is, omdat die definitie bepalend is voor elke implementatiebeslissing die daarop volgt.
Het Databricks Data Lakehouse is geen datawarehouse met toegevoegde lake-functionaliteiten, of een lake met daarop gemonteerde warehouse-governance. Het is een enkel open platform dat de transactionele betrouwbaarheid, schema-handhaving en queryprestaties van een datawarehouse biedt, terwijl de schaalbaarheid, openheid en ML-compatibiliteit van een data lake behouden blijven. De Lakehouse-architectuur op Databricks draait op open tabelformaten – Delta Lake en Apache Iceberg – wat betekent dat er geen vendor lock-in is op de opslaglaag en dat elke rekenengine die open standaarden ondersteunt, dezelfde tabellen kan lezen en ernaar kan schrijven.
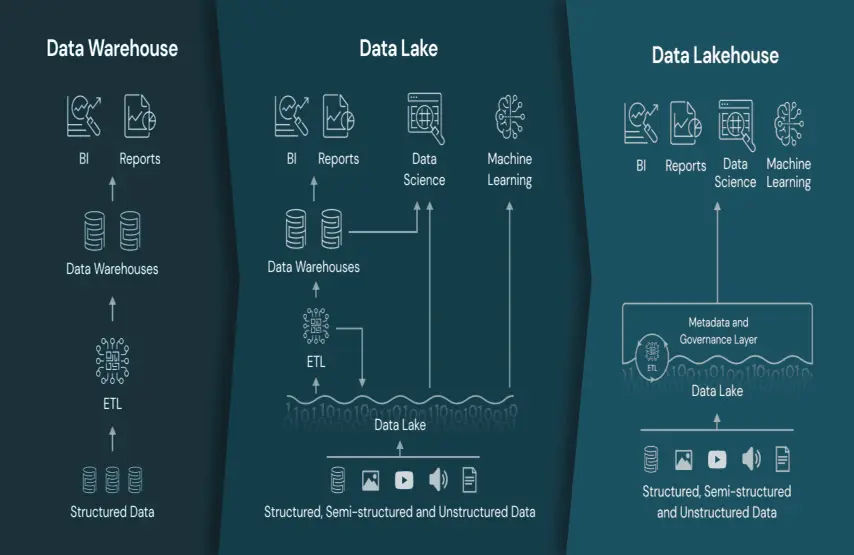 Bron -Databricks
Wanneer een datawarehouse en een data lake als aparte systemen naast elkaar bestaan, worden dezelfde gegevens twee keer ingevoerd, twee keer getransformeerd en twee keer op kwaliteit gecontroleerd – door verschillende teams, wat resulteert in verschillende cijfers. Elke nieuwe gegevensbron verhoogt deze overhead. Het is een structureel probleem, geen probleem met de datakwaliteit.
Wat doet Databricks Lakehouse?
De Lakehouse Databricks-architectuur elimineert dit door het ontwerp. Eén open platform – gebouwd opDeltameerEn de Medallion-architectuur ondersteunt BI-, streaming- en AI-workloads op dezelfde onderliggende data, zonder verplaatsing of replicatie.
De gegevens doorlopen de pipelinelagen eenmaal:
- Brons —Onbewerkte gegevens, exact bewaard zoals ontvangen van de bronsystemen, zonder enige transformatie.
- Zilver —Gereinigd, gevalideerd en verrijkt; schema-gecontroleerd en kwaliteitsgecontroleerd vóór elke analytische verwerking.
- Goud -geaggregeerd en geoptimaliseerd voor het specifieke rapportage-, dashboard- of modeltrainingsdoel waarvoor het bedoeld is.
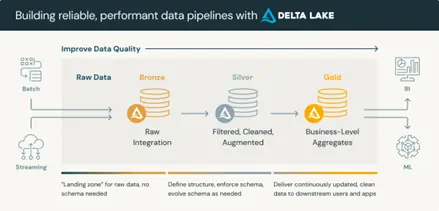
Eén data-invoerpipeline. Eén transformatielogica. Eén versie van de meetwaarde.
Het elimineren van dubbele pipelines verkleint het faalrisico en vereenvoudigt het debuggen aanzienlijk. Wanneer er tijdens een business review een afwijking in de meetwaarden aan het licht komt, hoeft er slechts één pipeline onderzocht te worden en één transformatielogica gecontroleerd te worden – in plaats van drie. Deze vermindering van de diagnostische complexiteit is waar in productieomgevingen van Lakehouse het meest consistent tijd wordt bespaard aan engineeringuren.
Organisaties die gelaagde data-architecturen met duidelijke kwaliteitsborgingszones implementeren, melden een drievoudige verbetering van de betrouwbaarheid van de datapijplijn in vergelijking met organisaties die gebruikmaken van platte, ongestructureerde data lake-architecturen.
Traditionele data lakes missen transactionele garanties. Gelijktijdige schrijfbewerkingen leiden tot gedeeltelijke updates. Mislukte taken laten tabellen in een onduidelijke staat achter. Schemawijzigingen worden ongemerkt doorgevoerd, waardoor latere analyses worden verstoord. In gereguleerde sectoren vormt het ontbreken van een controleerbare datahistorie een risico voor de naleving van wet- en regelgeving, en niet slechts een technisch ongemak.
Wat doet Databricks Data Lakehouse?
Delta Lake lost het transactieprobleem op het niveau van het opslagformaat op. Elke schrijfbewerking wordt volledig voltooid of vindt helemaal niet plaats — geen gedeeltelijke resultaten, geen stille corruptie. Schemahandhaving voorkomt dat wijzigingen stroomopwaarts zich verspreiden naar analytische datasets zonder expliciete validatie op pipelineniveau. Time-travel stelt engineers in staat om elke eerdere versie van een tabel op te vragen of te herstellen — wat voorheen uren duurde, duurt nu nog maar minuten.
Apache Iceberg breidt deze garanties uit naar omgevingen met meerdere engines via een open specificatie, waardoor dezelfde transactionele eigenschappen gelden ongeacht welke rekenengine de tabel leest of schrijft.
Tegen 2026 zal 60% van de organisaties die hun data op opslagniveau niet goed beheren, ten minste één ernstig compliance-incident ondervinden dat verband houdt met AI- of analyse-uitkomsten.
Impact op het bedrijfsleven:
Wanneer een compliance-audit documentatie over de herkomst van gegevens vereist, of wanneer een AI-initiatief een governance-review door de CISO ondergaat, bieden de mogelijkheden voor tijdreizen en dataherkomst van de Databricks Data Lakehouse-architectuur gestructureerd, doorzoekbaar bewijsmateriaal dat met handmatige documentatieprocessen niet mogelijk is. De voorbereidingstijd voor een audit daalt van dagen naar uren – niet omdat het proces is veranderd, maar omdat het bewijsmateriaal bij elke stap automatisch is vastgelegd.
In gefragmenteerde architecturen wordt governance in elke omgeving afzonderlijk toegepast: toegangsrechten voor datawarehouses in het ene systeem, beheer van datalakes in een ander, en toegang tot machine learning wordt onafhankelijk beheerd. De herkomst van gegevens wordt binnen de omgevingen bijgehouden, niet tussen omgevingen. Wanneer een AI-initiatief een CISO-evaluatie ondergaat met vragen over welke data het model heeft getraind, wie toegang had en welke beheersmaatregelen er waren, kan een architectuur zonder governance hier geen antwoord op geven. Projecten komen dan stil te liggen.
78% of business executives lack strong confidence that they could pass an independent AI governance audit within 90 days. The governance gap is not a peripheral concern. It is the central obstacle between AI experimentation and AI at scale.
Wat doet Databricks Lakehouse?
Unity-catalogusBiedt één beheerlaag voor het gehele Lakehouse-platform: data, analyses, ML-modellen, notebooks en dashboards worden beheerd in één metastore met consistente toegangsregels. Controle op rij- en kolomniveau wordt toegepast met behulp van standaard ANSI SQL. End-to-end tracering volgt elke transformatie van de ruwe bron via elke pipelinelaag tot de uiteindelijke model- of rapportoutput – in een doorzoekbare grafiek.
Unity Catalog moet worden geconfigureerd voordat pipelines worden gebouwd en voordat modellen worden getraind. Het achteraf toevoegen van governance aan een werkend systeem kost aanzienlijk meer – in termen van ontwikkeltijd en vertrouwen van stakeholders – dan het vanaf het begin correct ontwerpen.
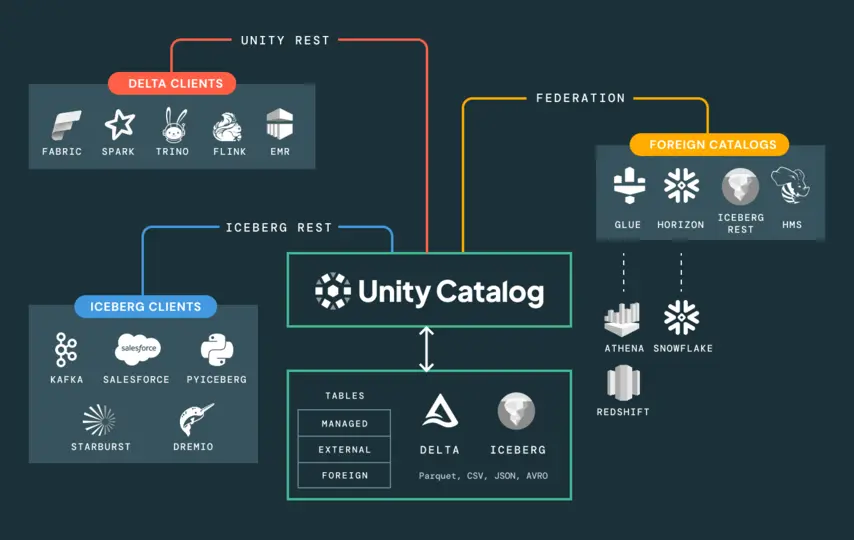 Bron -Databricks Unity Catalog
Handmatig gecodeerde streamingpipelines vereisen dat engineers elke mogelijke foutmodus expliciet onderhouden – checkpointbeheer, statusherstel, schema-evolutie, herhalingslogica. Op grote schaal wordt dit een onderhoudslast die ten koste gaat van de capaciteit die nodig is voor de ontwikkeling van nieuwe systemen. Fouten in pipelines zijn geen uitzonderingen. Het zijn terugkerende gebeurtenissen waar de storingsdiensten op gebaseerd zijn.
Wat doet Databricks Lakehouse?
Lakeflow Pipelines (formerly Delta Live Tables) inverts the pipeline development model from imperative to declarative. Engineers define what the data should look like and what quality standards it must meet. Lakeflow Pipelines manages dependency resolution, auto-scaling, error handling, retry logic, and data quality enforcement automatically — through configurable expectations that warn, quarantine, or halt on quality violations.
Lakeflow Jobs extends this to multi-step orchestration: scheduling complex pipelines that combine notebooks, Lakeflow pipeline tasks, and ML models, with built-in repair and rerun capabilities that resume from the point of failure rather than restarting from scratch.
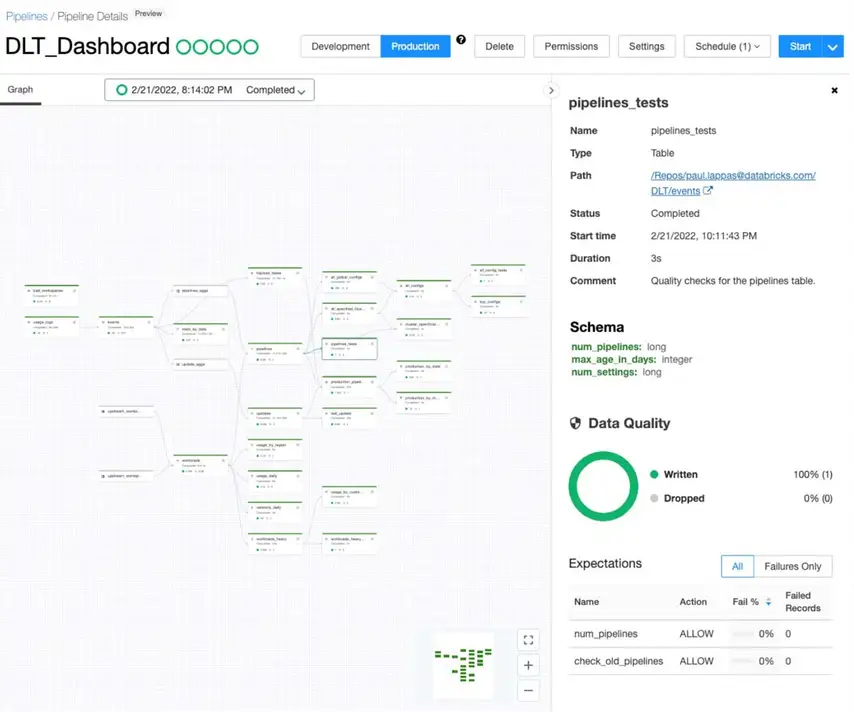 Bron -Databricks DLT
When a pipeline fails in a Lakeflow Pipelines environment, engineers resolve the upstream cause and resume from the point of failure — the platform handles the rest. In a hand-coded streaming environment, the same failure requires a full diagnostic trace, manual state reconstruction, and a restart from scratch. At scale, that difference in recovery time is where the operational return on declarative Lakehouse architecture is most visible.
Handmatig clusterbeheer zorgt voor aanhoudende kosten en overhead. Kiest u voor de piekbelasting, dan betaalt u voor inactieve rekenkracht buiten de piekuren. Kiest u voor de gemiddelde belasting, dan ontstaan er wachtrijen voor taken tijdens piekuren. Handmatige afstemming — VACUUM, OPTIMIZE, partitieaanpassingen — is tijdrovend en inconsistent voor verschillende soorten workloads.
Wat doet Databricks Lakehouse?
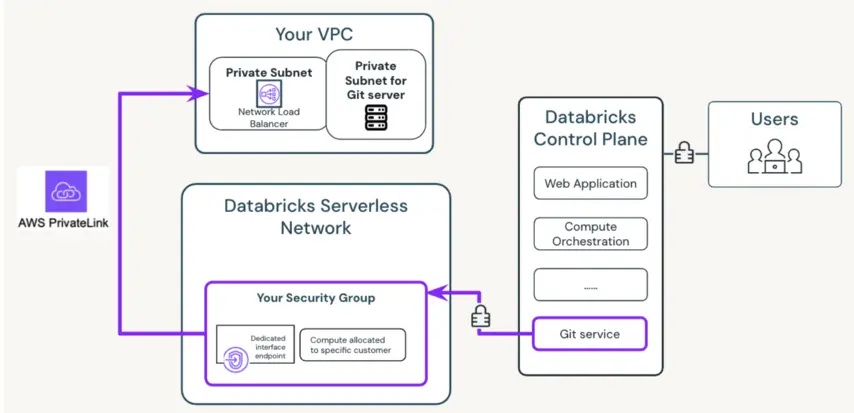
Serverless computing op het Databricks Lakehouse-platform abstraheert het infrastructuurbeheer volledig. Compute wordt direct geprovisioneerd wanneer een workload start en vrijgegeven wanneer deze is voltooid — geen clusterconfiguratie, geen beheer van inactieve resources, geen vertragingen bij een koude start. De beveiligingsarchitectuur scheidt het besturingsvlak van het datavlak, waardoor klantgegevens in het eigen cloudaccount van de klant blijven, versleuteld in rust en tijdens transport — ongeacht of het is geïmplementeerd als een AWS Data Lakehouse of een Azure Databricks Lakehouse.
Predictive Optimization sluit de cyclus van handmatige afstemming: AI-gestuurde algoritmen analyseren continu querypatronen en voeren achtergrondonderhoud uit — VACUUM, OPTIMIZE — alleen wanneer de prestatieanalyse een significante verbetering aangeeft. Handmatige afstemming wordt vervangen door geautomatiseerd, op ROI gebaseerd onderhoud.
Weet je dat?
Het Databricks Lakehouse-platform met gestructureerd computerbeheer behaalde een ROI van 247% over drie jaar, met een terugverdientijd van minder dan zeven maanden!
 Bron -Databricks
Lagere totale eigendomskosten, snellere uitvoering van workloads en consistent hoge queryprestaties zonder handmatige afstemming. De engineeringcapaciteit wordt omgeleid van infrastructuurbeheer naar pipeline-ontwikkeling – werk dat in de loop der tijd in waarde toeneemt!
Once the architecture is in place, the five challenges above resolve into a set of compounding advantages:
- One pipeline, one version of the truth. A single ingestion pipeline replaces duplicated warehouse and lake logic, so every metric traces back to one transformation rather than three competing ones.
- Reliability built into the storage layer. Delta Lake brings transaction reliability and schema enforcement, and turns audit preparation into a simple query instead of a couple of days of manual work.
- Governance with true end-to-end lineage. Unity Catalog manages data, notebooks, models, and dashboards in a single metastore, giving every function shared lineage and acting as the bridge between the CISO and each stage of an AI initiative.
- Declarative pipelines that run themselves. With Lakeflow Pipelines and Workflows, engineers define the result they want and the platform takes responsibility for scaling, retrying, and recovering from failure.
- Lower cost without losing performance. Serverless compute and Predictive Optimisation automate cluster management and tuning, so overall spend drops while query performance holds steady.
Taken together, these benefits redirect engineering capacity from maintaining fragmented infrastructure to building the pipelines and models that compound in value over time.
The sequencing of implementation decisions determines whether the Databricks Lakehouse architecture delivers or accumulates a new category of technical debt. Provision Unity Catalog first. Enforce compute governance before workloads scale. Adopt Lakeflow Pipelines before manual orchestration becomes the liability your on-call rotation is built around. These decisions are harder to retrofit than to get right from the start — and the cost of getting them wrong shows up quickly in cloud bills, compliance reviews, and engineering morale.
This is precisely where having navigated these decisions across multiple production environments makes the difference.
Polestar Analytics is a certified Databricks consulting partner that helps enterprises build production-grade data, AI, and analytics solutions on Databricks. we built Lakehouse architectures across logistics, manufacturing, and financial services — implementing Unity Catalog governance frameworks, Lakeflow pipeline architectures, and compute policies that hold up under real production pressure. We do not consult from a distance. We have made these calls under deadline, in production, with real stakes.
If your organisation is evaluating the Databricks Lakehouse platform for the first time or trying to unlock more from an existing deployment that has not delivered on its architectural promise — the right starting point is a conversation about where your architecture currently stands and what sequencing makes sense given your data estate, team, and AI roadmap.
- Fragmentation is an architecture problem, not a tooling one. The Lakehouse runs BI, streaming, and AI on one open platform, so data flows once instead of being built and reconciled three times.
- Five challenges, five mechanics: medallion architecture (duplicate pipelines), Delta Lake (reliability), Unity Catalog (governance), Lakeflow Pipelines and Workflows (orchestration), and serverless plus Predictive Optimisation (cost).
- Sequencing decides the outcome. Provision Unity Catalog first, govern compute early, and adopt Lakeflow Pipelines before manual orchestration becomes a liability. These are far harder to retrofit than to get right upfront.
For phased migration projects, the duration usually depends on the size and complexity of the existing data estate. However, the average timeframe is a couple of months to less than one year. Moreover, carrying out a pilot phase with one workload that has high value could help achieve measurable results faster.
Yes. It operates on AWS, Azure, and Google Cloud, so with it, there is no hassle with moving services. That's how you can ensure that all your information stays within your environment and that infrastructure changes aren't disruptive.
Not from scratch. Teams already fluent in SQL, Python, and Spark transfer their skills directly, and the declarative model in Lakeflow Pipelines often reduces the code they maintain. The main shift is conceptual, moving from managing infrastructure to defining outcomes.