


 Kshitij GuptaData-strateeg
Meld u aan om de nieuwste inzichten en updates over technologie, AI & data-analyse, datawetenschap en innovaties van Polestar Analytics te ontvangen.
 Vat dit blogbericht samen met:
Decennialang betekende het bouwen van een realtime AI-applicatie het beheren van twee fundamenteel incompatibele systemen. De analyse- en machine learning-infrastructuur bevond zich aan de ene kant – in een data lake of datawarehouse dat was ontworpen voor hoge doorvoersnelheden. De operationele database bevond zich aan de andere kant – een standalone PostgreSQL-instantie die vastlegde wat gebruikers op dat moment daadwerkelijk deden. Daartussen bevond zich een kwetsbare pipeline: change data capture-taken, ETL-synchronisaties en replicatielogica die volgens een vast schema vastliepen en latentie introduceerden die in minuten, en niet in milliseconden, werd gemeten.
De zakelijke kosten van die architecturale fragmentatie zijn goed gedocumenteerd. Organisaties lijden gemiddeld onder...$12,9 miljoenjaarlijks aan verliezen die direct toe te schrijven zijn aan slechte datakwaliteit — een cijfer dat nog hoger wordt wanneer realtime AI-systemen gedwongen worden te werken met verouderde data die door vertragingen in de dataverwerking zijn ontstaan.
Toch zullen organisaties tot 2026 60% van de AI-projecten stopzetten die niet worden ondersteund door data die geschikt is voor AI. Het knelpunt zit niet in de rekenkracht en ook niet in de kwaliteit van de modellen. Het zit hem in de afstand tussen de transactionele data en de AI-systemen die deze data proberen te verwerken.
Databricks Lakebase is het architectonische antwoord op die lacune. Operationele databases vertegenwoordigen een markt van meer dan 100 miljard dollar en vormen de basis van elke applicatie. Maar ze zijn gebaseerd op een decennia-oude architectuur, ontworpen voor applicaties die langzaam veranderen. Dit maakt ze moeilijk te beheren, duur en gevoelig voor vendor lock-in. AI introduceert een nieuwe reeks vereisten: elke data-applicatie, agent, aanbeveling en geautomatiseerde workflow heeft nu snelle,betrouwbare data met de snelheid en schaal van AI-agenten.
Sinds de lancering inJuni 2025De adoptie ervan is meer dan twee keer zo snel gegroeid als die van het datawarehouseproduct van Databricks, waarbij duizenden bedrijven productieworkloads rechtstreeks op hun operationele data uitvoeren.
De conventionele aanpak voor het bouwen van data-applicaties dwong tot een zware technische afweging. Je moest de informatieve use case – historische context, het genereren van ML-features, analytische query's – afwegen tegen de transactionele use case – vastleggen wat een gebruiker drie seconden geleden aanklikte, de voorraad in realtime bijwerken, de agentstatus tijdens een workflow behouden.
Het beheren van beide betekende dat er aparte databases moesten worden gebruikt die met elkaar verbonden waren door kwetsbare pijplijnen. De omvang van dat probleem is aanzienlijk: datateams melden gemiddeld 67 incidenten met pijplijnen per maand, en68%Teams hebben vier uur of langer nodig om een storing te detecteren wanneer die zich voordoet. Data-engineers werden pijplijnbrandweermannen. ML-modellen haalden gegevens op die al verouderd waren tegen de tijd dat ze binnenkwamen. Realtime AI-toepassingen bleken een contradictie op zich.
Lakebase op het Databricks-databaseplatformHet is meer dan alleen "Postgres op Databricks". Het is een verschuiving in de manier waarop we denken over operationele en analytische data die naast elkaar bestaan — beheerd, doorvraagbaar en aangedreven door hetzelfde platform.
In plaats van een aparte database op te zetten, reverse ETL-taken te bouwen en authenticatie op twee plaatsen te beheren, kunnen teams nu beheerde Lakehouse-tabellen synchroniseren met PostgreSQL.querytijden in milliseconden, bouw applicatiestatus- en transactietabellen direct inDatabricks Lakebaseen beveilig alles met behulp van Databricks-identiteiten en Postgres-rollen.
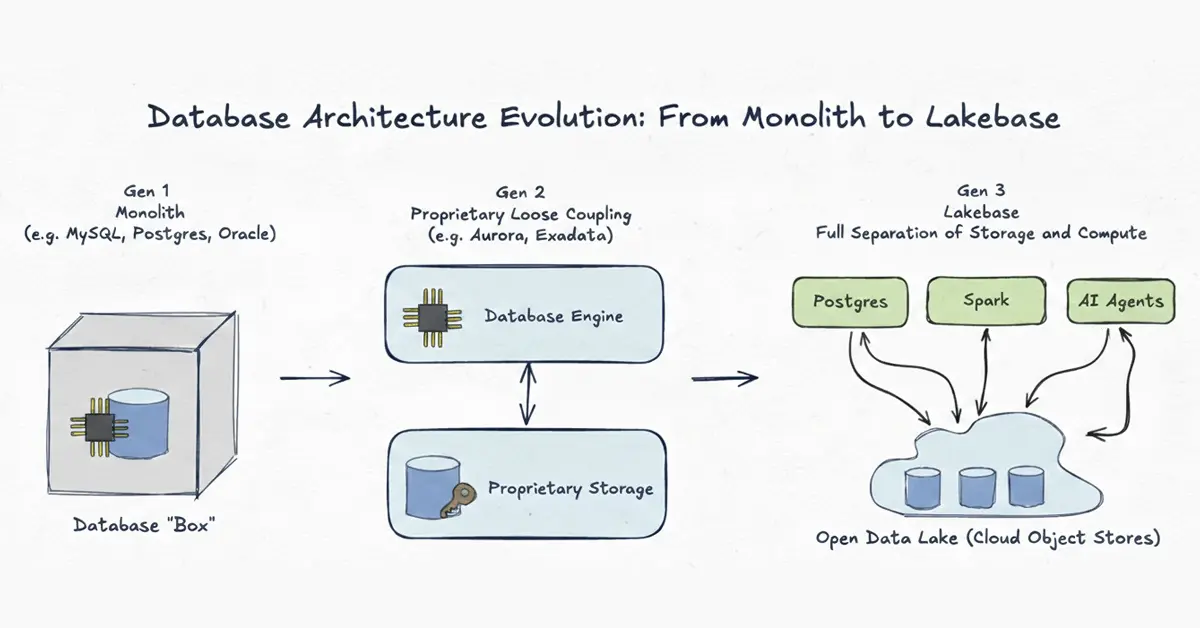
Hoe de databasearchitectuur zich over drie generaties heeft ontwikkeld: van monolithische on-premises systemen tot volledig ontkoppelde, open Lakebase-architectuur. De scheiding van rekenkracht en opslag is de belangrijkste doorbraak die realtime AI-toepassingen mogelijk maakt zonder kwetsbare pipelines.
Databricks LakebaseVereenvoudigt applicatieontwikkeling met een bewezen OLTP-database, zonder de problemen van databasebeheer. Het elimineert complexe, op maat gemaakte ETL-pipelines en zorgt ervoor dat transactionele data wordt geïntegreerd in analyses en Databricks AI-native applicaties. Teams kunnen ontwikkelingsvertragingen voorkomen door gebruik te maken van vertrouwde,Open-source PostgreSQL met bestaande bibliothekenframeworks en SQL — met ontkoppelde reken- en opslagprocessen voor onafhankelijke schaling, herstel naar een specifiek tijdstip en de mogelijkheid om een database te versioneren zoals code.
De Databricks Lakebase-architectuurHet platform combineert de betrouwbaarheid en bekendheid van PostgreSQL met moderne databasefunctionaliteiten, waaronder autoscaling, scale-to-zero, branching en instant restore. Deze functies maken flexibele ontwikkelworkflows, kostenefficiënte processen en snelle iteratie mogelijk. Het platform integreert met realtime feature serving voor ML-modellen en Feature Store, agentstatus voor AI-agenten en transactionele data voorDatabricks-appsof een applicatie die ermee verbonden is.
Gegevens worden in twee richtingen tussen het Lakehouse en Lakebase uitgewisseld:
Beide richtingen. Geen aangepaste pipelines!
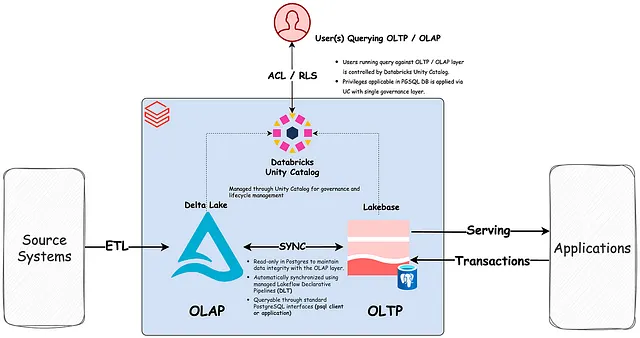
De Databricks Lakebase-architectuur: transactionele berekeningen (Postgres) draaien onafhankelijk bovenop open-formaat opslag in de lake, waardoor OLTP- en OLAP-workloads worden verenigd op één beheerd platform — zonder ETL-pipelines ertussen.
DeLakebase Databricks-platformbiedt een reeks mogelijkheden van productiekwaliteit:
| Functie | Wat het doet | Waarom het belangrijk is |
|---|---|---|
| Serverloze automatische schaling en schaalbaarheid naar nul | De computer past zich dynamisch aan het verkeer aan; hij schakelt zichzelf uit wanneer hij inactief is. | Elimineert verspilling van geld aan ongebruikte infrastructuur. |
| Directe databasevertakking | Creëert binnen enkele seconden kopieën van productiedata zonder enige kopie. | Risicovrij testen zonder volledige datasets te dupliceren. |
| Point-in-Time Recovery (PITR) | Herstelt de database naar een willekeurige milliseconde binnen het bewaarvenster. | Bescherming tegen onbedoelde verwijderingen en applicatiefouten. |
| Unity Catalog Governance | Eén uniform beveiligingsmodel voor operationele en analytische gegevens. | Eén toegangsbeheerbeleid voor het gehele data-landschap. |
| Tabellen synchroniseren | Zorgt ervoor dat de gegevens van Lakehouse en Lakebase automatisch op elkaar zijn afgestemd. | Geen kwetsbare pipelines; geen handmatige synchronisatietaken. |
| Postgres 17-ondersteuning + pgvector | Volledige PostgreSQL-compatibiliteit, inclusief AI-native vectorzoekopdrachten. | Gebruik bestaande tools; schakel semantisch en gelijkeniszoeken standaard in. |
De mogelijkheid om branches te creëren verdient bijzondere aandacht. Net als Git voor je database, stellen branches teams in staat om binnen enkele seconden geïsoleerde omgevingen te creëren, los van de productiedata. Zo kunnen ze schemawijzigingen testen, nieuwe applicatielogica valideren en belastingstests uitvoeren, zonder de live workloads aan te raken of de kosten van volledige dataduplicatie te hoeven dragen.
Het opzetten van een productieklare applicatie op het Lakebase Databricks-platform volgt een gestructureerd traject.Zowel de Microsoft Azure Databricks Lakebase-documentatie als de Databricks-blog over het bouwen van productieklare apps beschrijven dit uitvoerig.
De belangrijkste fasen zijn:
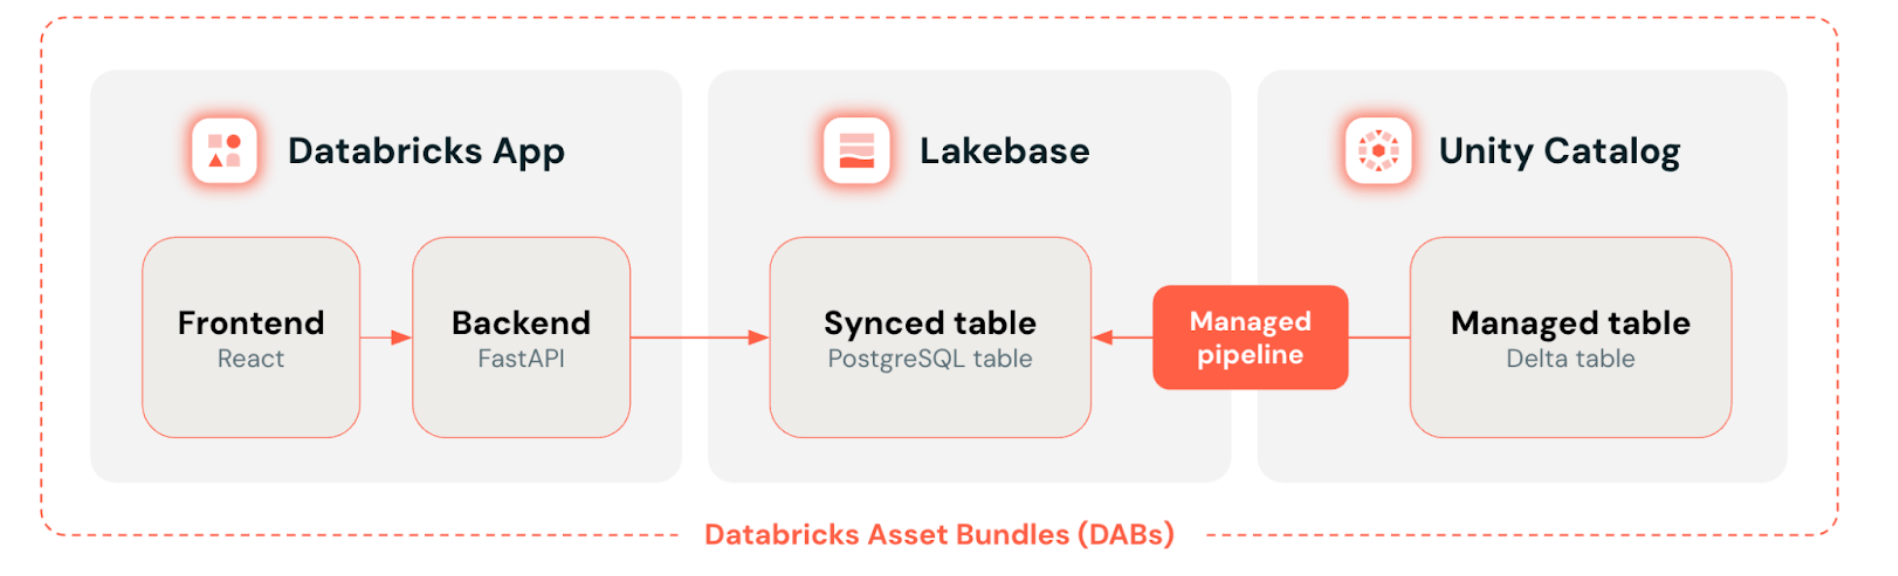
Hoe een productiegereed data-applicatie wordt samengesteld op het Lakebase Databricks-platform: Databricks Apps aan de front-end, Databricks Lakebase als de transactionele datalaag, Unity Catalog voor het beheer van gecontroleerde Delta-tabellen met automatische synchronisatie — alles geïmplementeerd als code via Databricks Asset Bundles.
De toepassingsmogelijkheden van de Lakebase-database bestrijken diverse sectoren en architectuurpatronen.Databricks Lakebaseidentificeert de volgende primaire soorten werkbelasting:
| Industrie | Gebruiksvoorbeeld van de Lakebase-database | Wat het vervangt |
|---|---|---|
| Detailhandel en e-commerce | Gepersonaliseerde aanbevelingen en realtime gerichte aanbiedingen | Op zichzelf staande aanbevelingssystemen die worden gevoed door vertraagde batchverwerkingsprocessen. |
| Gezondheidszorg | Gegevensbeheer van klinische onderzoeken in combinatie met voorspellende diagnostische modellen. | Geïsoleerde OLTP-databases, losgekoppeld van analytische ML-lagen. |
| Financiële diensten | Geautomatiseerde handels- en streamingfraudedetectie-analyses | Gescheiden operationele databases met CDC-pipelines voor analyses. |
| Productie | Werkprocessen voor het verwerken van machinetelemetrie en voorspellend onderhoud. | Lokale historie-systemen met handmatige data-exporttaken |
| Media & Entertainment | Realtime personalisatie van content en tracking van publieksbetrokkenheid | Gefragmenteerde gebeurtenisregistratie met vertraagde synchronisatie van het datawarehouse |
Databricks LakebaseHet is ontwikkeld voor een specifiek probleem. Het is geen universele vervanging voor elke operationele database. Hier volgt een duidelijk kader voor het beoordelen van de geschiktheid:
Gebruik Databricks Lakebase wanneer:
Azure Databricks LakebaseGebruikers dienen rekening te houden met de huidige regionale beschikbaarheid van Autoscaling op het platform – die de belangrijkste AWS- en Azure-regio's omvat – alvorens latencygevoelige wereldwijde implementaties te plannen.Azure-documentatieGeeft een overzicht van de ondersteunde regio's en configuratiespecificaties.
Databricks Lakebase ondersteunt een latentie van minder dan 10 ms.voor workloads met een hoge doorvoer, wat het overgrote deel van de AI-toepassingsvereisten voor bedrijven dekt. De combinatie vanDatabricks Lakebase met de OLTP-databaseDit maakt het mogelijk om architectuurproblemen op een fundamenteel andere manier op te lossen, met een duidelijke weg weg van kwetsbare ETL-pipelines en de gedwongen scheiding van analytische en operationele lagen.
Databricks LakebaseLakebase is nu algemeen beschikbaar op AWS en in bèta op Azure, met een groeiend ecosysteem van lanceringspartners die de mogelijkheden ervan hebben gevalideerd voor databasemodernisering, realtime applicatieontwikkeling en agentische AI-workflows. Databricks Lakebase-lanceringspartners staan klaar om klanten te helpen profiteren van deze verschuiving, nadat ze de mogelijkheden ervan hebben gevalideerd.Lakebase Databricks-platformvoor het moderniseren van databases, het bouwen van realtime-applicaties en het implementeren van AI-workflows met behulp van agenten.
Polestar Analyticsbehoort tot die lanceringspartners. Als eenDatabricks AI-nativeImplementatiespecialist in data-engineering, AI-toepassingen enDatabricks Lakebase-architectuurPolestar Analytics biedt de implementatiemethodologie — architectuurontwerp, dataflowmapping, governanceconfiguratie en applicatie-integratie — die een technisch capabel platform transformeert in een productiesysteem dat betrouwbaar presteert en voorspelbaar schaalbaar is. Het Databricks-databaseplatform elimineert de architecturale bottleneck. Een bewezen implementatiepartner elimineert het implementatierisico.
Integratiekaart van Databricks Lakebase: Waar Lakebase zich bevindt in het volledige platform
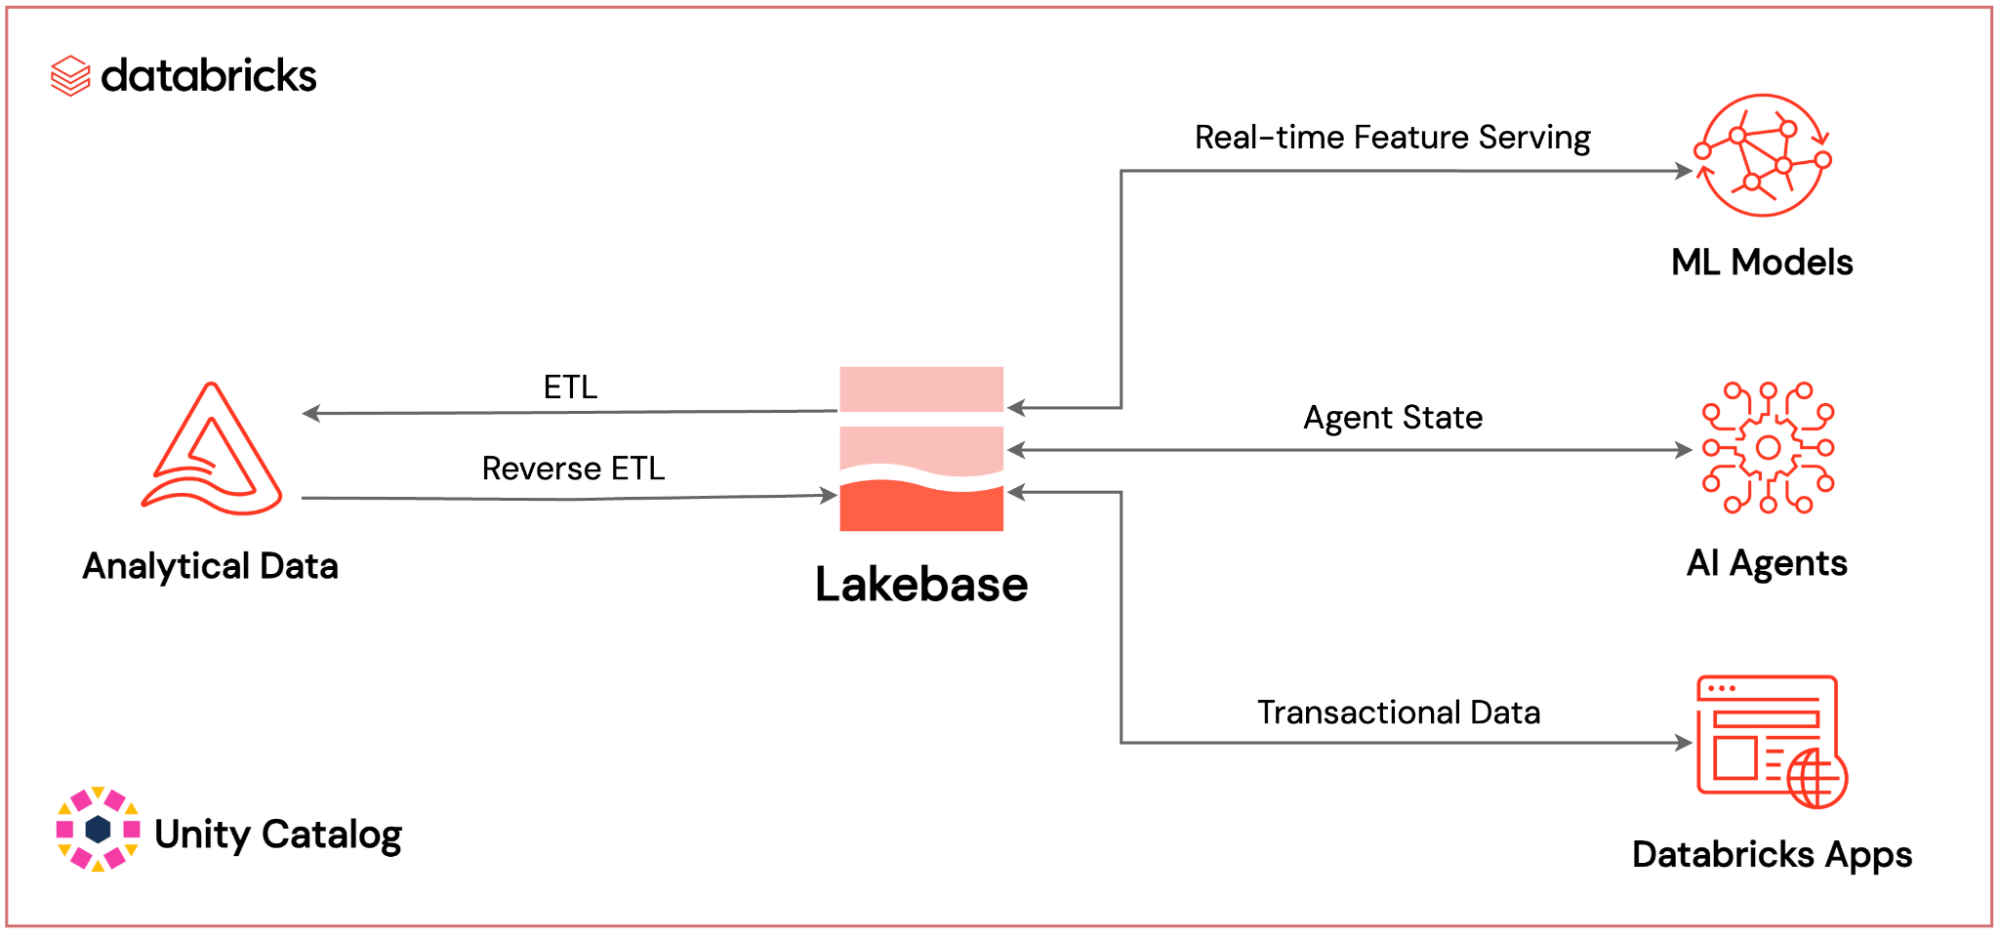
De positie van Databricks Lakebase binnen het complete, native Databricks AI-platform: het levert realtime ML-functionaliteit, bewaart de status van AI-agenten en beheert transactionele applicatiegegevens – allemaal beheerd door Unity Catalog.
Bouw je realtime AI-applicatie op Databricks Lakebase.VanDatabricks Lakebase-architectuurVan ontwerp tot implementatie in productie — Polestar Analytics begeleidt u in elke fase van uw implementatie.
Neem contact op met ons engineeringteam.Lakebase beheert bidirectionele gegevensverplaatsing via twee speciale mechanismen: Synced Tables en Lakehouse Sync, die beide zonder aangepaste pipelines werken. Consistentie wordt op platformniveau gewaarborgd, waardoor handmatige ETL-taken die traditioneel kunnen afwijken, stilletjes mislukken of vertraging veroorzaken, overbodig worden.
Nee, Lakebase is compatibel met PostgreSQL 17, dus bestaande drivers, ORM's, SQL-query's en bibliotheken blijven zonder aanpassingen werken. De verandering zit hem in waar PostgreSQL draait en waarmee het verbinding maakt, niet in hoe ontwikkelaars er dagelijks mee omgaan.
Ja, teams gebruiken het tegenwoordig voor operationele dashboards, realtime personalisatie en transactionele apps die simpelweg schone, gecontroleerde data nodig hebben zonder de overhead van een dataverwerkingspipeline. De AI-mogelijkheden zijn beschikbaar wanneer je er klaar voor bent, maar ze zijn geen vereiste om vanaf dag één waarde te behalen.
Over de auteur
Data-strateeg
De meeste data geeft antwoord op vragen. De juiste data verandert de richting.
Gerelateerde blog
 Astha Chadha